
Diagnóstico
Las fallas repetidas suelen compartir una causa
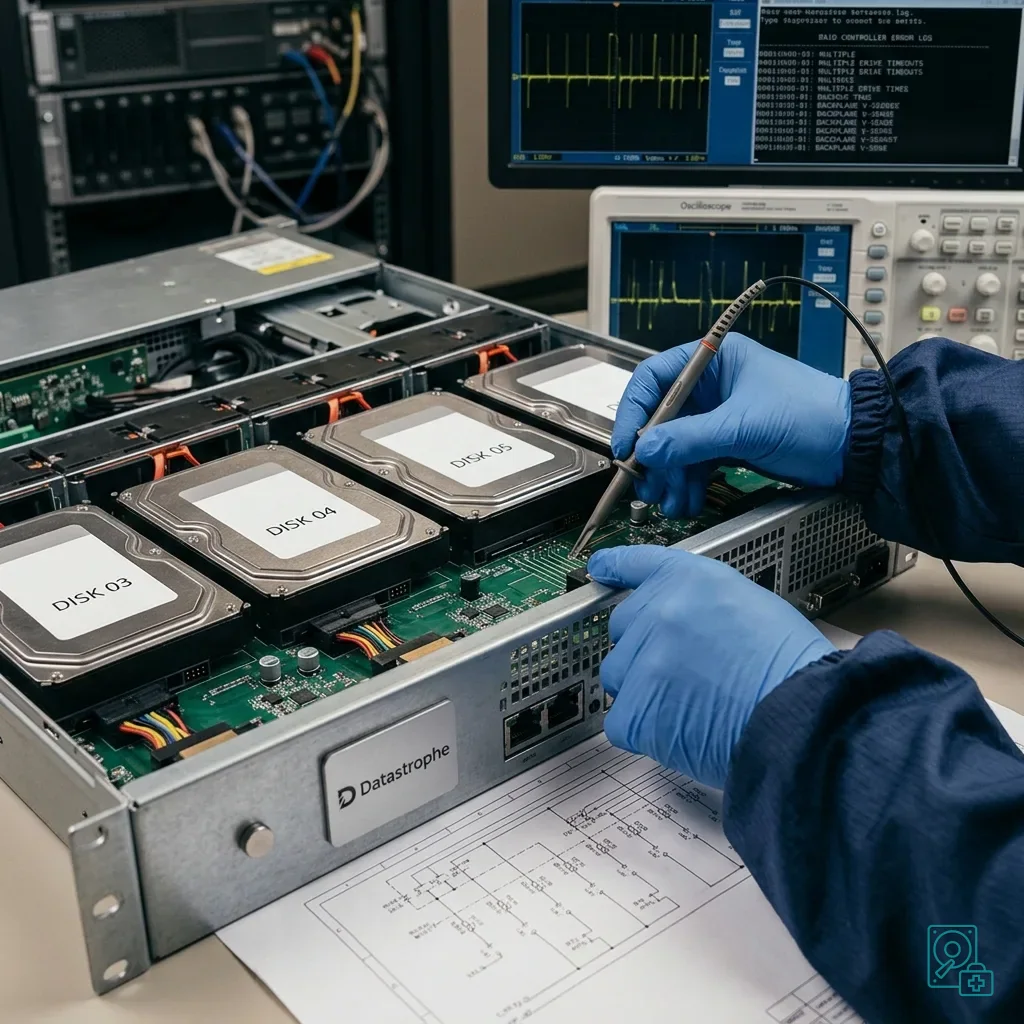
Ante el error de un disco de servidor suele reemplazarse la unidad. Si varias alertas aparecen en poco tiempo, el diagnóstico debe ampliarse a calor, energía, backplane, controlador RAID, vibraciones, firmware y carga de reconstrucción.
Un servidor concentra dependencias. Las unidades trabajan de forma continua dentro de una bahía común y comparten temperatura y energía. Una secuencia de fallas no tiene por qué ser una serie de casualidades independientes.
Los signos se leen juntos: alertas SMART, sectores reasignados, unidades que desaparecen, lentitud de I/O, reconstrucción estancada, volumen degradado y avisos del controlador, las fuentes o los ventiladores. Una alerta aislada puede tener una explicación simple; la acumulación exige detenerse y correlacionar la cronología.
La recuperación de datos de servidor presenta la atención del servicio. Aquí se analiza la mecánica de las fallas repetidas, que la urgencia suele interpretar mal.
Reemplazar una unidad detrás de otra sin descubrir la causa es el riesgo principal. Cada reconstrucción somete a una carga intensa a las unidades restantes; si alguna ya está frágil, esa exigencia puede desencadenar una pérdida mayor.
También se desconfía de alertas que desaparecen tras reiniciar. Volver en línea no cierra el incidente. Una conexión o fuente límite puede generar errores intermitentes, más difíciles de interpretar que una falla total.
Diagnóstico
Verificar RAID, backplane y energía
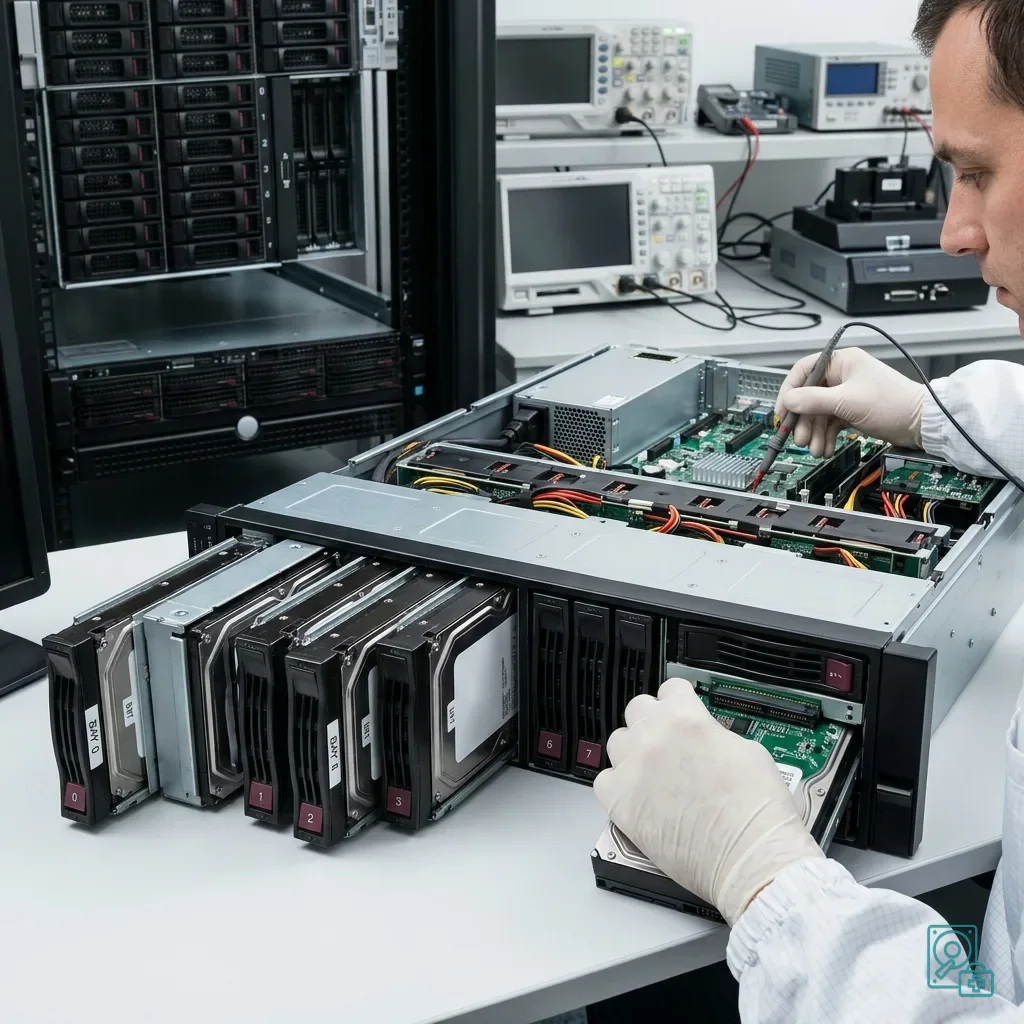
El RAID puede ocultar ciertas fallas, pero no corrige la causa común. Un controlador inestable, un backplane defectuoso o una alimentación irregular pueden afectar a varios discos. Reemplazar únicamente las unidades no resuelve esa capa compartida.
El backplane merece atención: conectores gastados, oxidación, una inserción deficiente o una bahía dañada pueden hacer que una unidad desaparezca de forma intermitente. La bitácora RAID puede parecer una falla del disco aunque la unidad no sea la única responsable.
El calor también influye. Un rack mal ventilado, con polvo o temperatura alta acumula errores en las unidades con mayor carga o peor refrigeradas.
El artículo sobre servidores y datos críticos recuerda que hay que priorizar servicios. El diagnóstico material evita que la reanudación destruya las últimas fuentes utilizables.
Los registros se guardan antes de que roten. Las bitácoras del RAID, el sistema, el hipervisor, la supervisión y SMART permiten reconstruir qué disco alertó primero, qué reconstrucción comenzó y qué bahía perdió contacto.
Esa cronología diferencia una unidad realmente averiada de otra desconectada en el peor momento y evita retirar un medio todavía imprescindible para la coherencia del volumen.
Diagnóstico
Evitar reconstrucciones en bucle
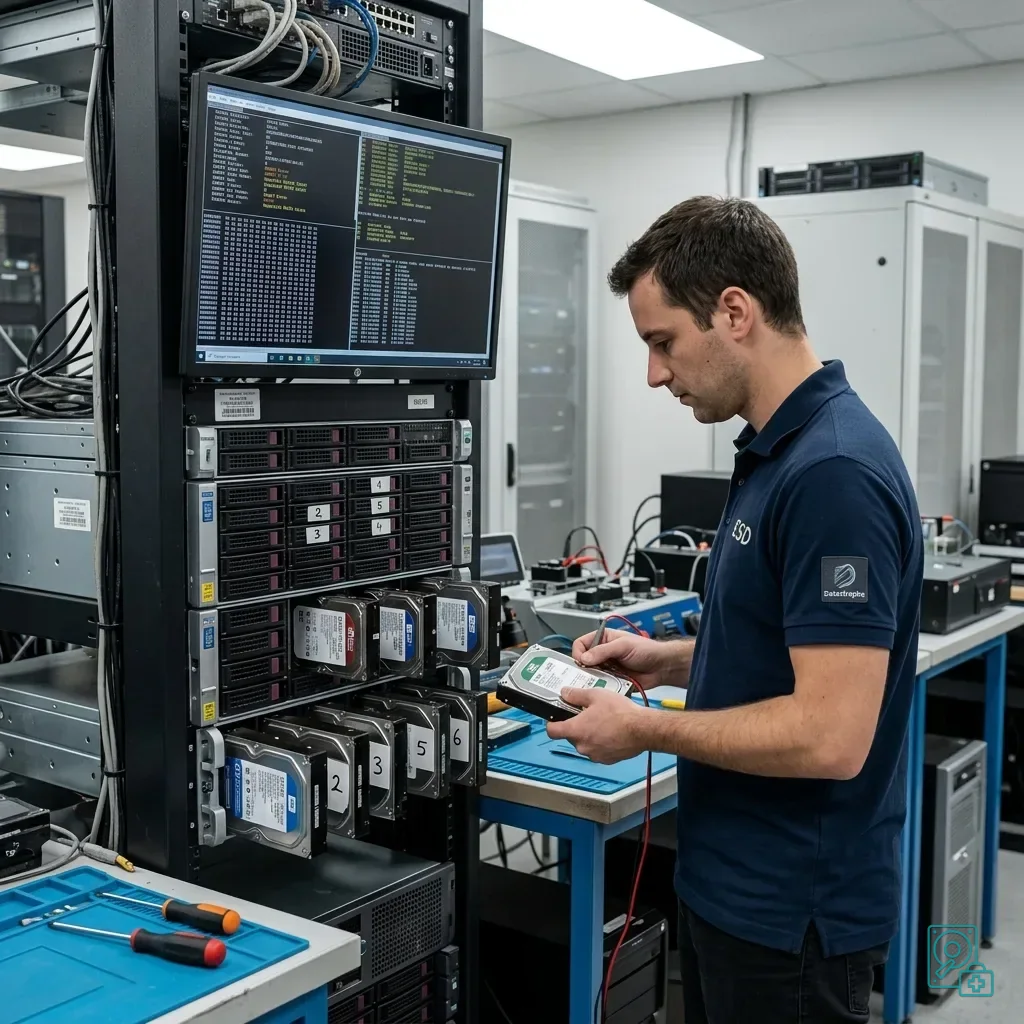
Reconstruir es útil con un contexto sano. Resulta peligroso si hay varias unidades inestables, errores recurrentes o una causa común sin identificar. Repetir reconstrucciones puede consumir las últimas lecturas posibles.
Se evitan reemplazos sucesivos, inicializaciones, importaciones forzadas, el borrado del estado foreign, ampliaciones y restauraciones en el mismo lugar sin documentar. Estas acciones alteran metadatos necesarios para reconstruir el arreglo.
Antes de reconstruir se preservan orden, configuración, registros y estado. Si los datos son críticos y los medios inestables, puede ser preferible obtener imágenes técnicas.
El artículo sobre RAID, redundancia y límites explica que tolerancia y respaldo no son equivalentes. Ante fallas repetidas, la tolerancia puede agotarse muy deprisa.
Un volumen montado tampoco es necesariamente confiable. El servidor puede reiniciar después de la reconstrucción y aun así contener archivos incoherentes o bases dañadas. La reanudación debe incluir control de calidad.
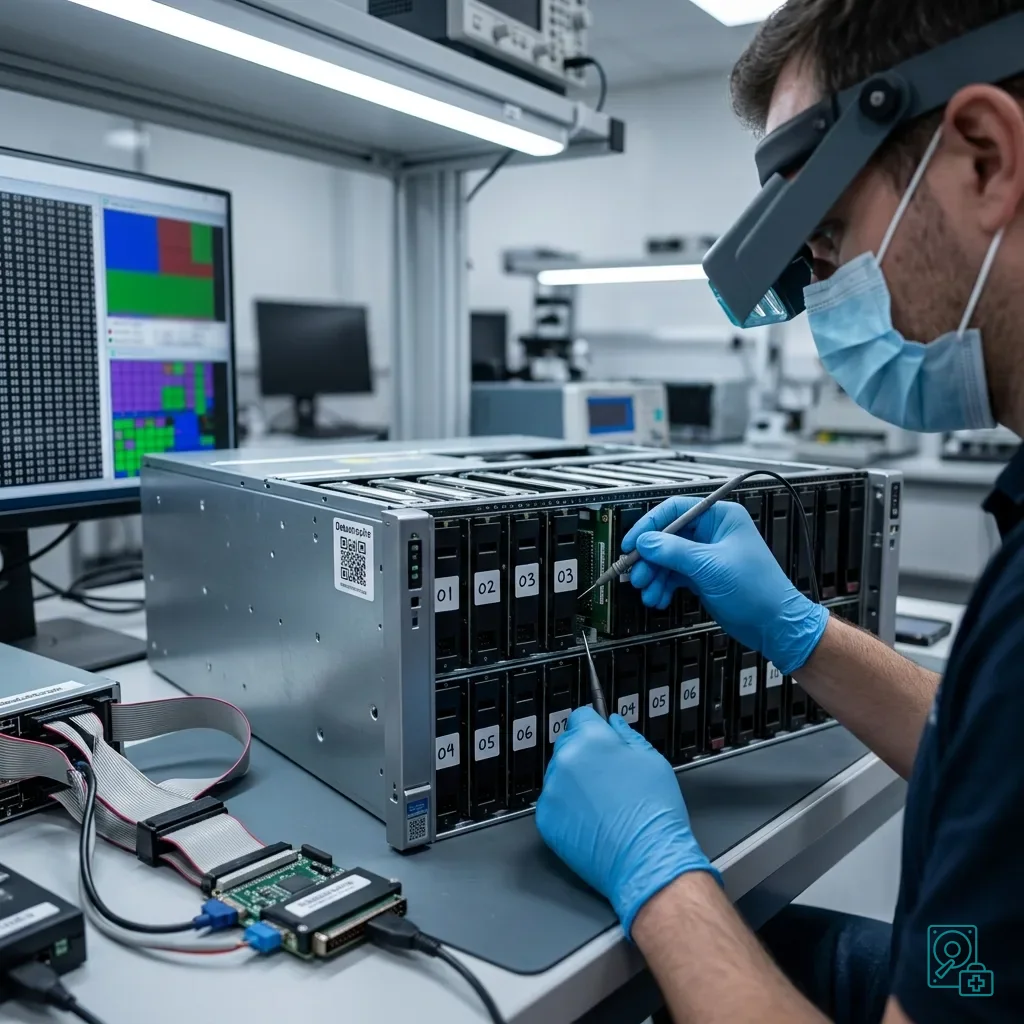
Diagnóstico
Priorizar servicios y datos críticos
En un servidor, base de negocio, compartido, correo, volúmenes de VM y producción no tienen el mismo peso. La jerarquía debe estar definida antes de diagnosticar.
La actividad puede reanudarse sobre una copia o un respaldo sin sobrescribir fuentes. Incluso si se restaura rápido, se conservan discos y configuración para el análisis posterior.
Las dependencias importan: una base sin registros transaccionales, una VM sin descriptor o un recurso sin permisos puede ser parcial pero difícil de operar. Se valida según uso real.
El plan de recuperación de datos de empresa completa esta lógica. La técnica es más eficaz cuando las prioridades de negocio ya están identificadas.
La comunicación interna debe ser factual: «volumen degradado, reconstrucción detenida, discos 2 y 4 inestables, contabilidad prioritaria» ayuda más que una descripción vaga y evita decisiones contradictorias.
Diagnóstico
Documentar la prevención
Después del incidente se busca la causa. Si intervinieron calor, backplane o energía, cambiar discos no basta. Se revisan entorno, supervisión, copias y procedimiento de reconstrucción.
Las alertas se prueban. Un aviso SMART o RAID ignorado durante días puede transformar una falla simple en un incidente completo. La prevención depende tanto de la reacción como de la tecnología.
Las copias deben poder restaurarse. Una versión no probada, antigua o en el mismo entorno no garantiza continuidad. El RAID cubre ciertos escenarios, no todas las pérdidas.
Una ficha reúne modelo, controlador, nivel RAID, orden, capacidades, firmware, ubicación, servicios y procedimientos. Durante el incidente permite decidir sin ensayos peligrosos.
Datastrophe puede analizar fallas repetidas o reconstrucciones difíciles para identificar causas probables, preservar los medios y recuperar las prioridades sin relanzar operaciones destructivas.
En entornos virtualizados, el análisis incluye volúmenes de VM, snapshots y datastores. Una falla física del servidor puede dejar discos virtuales incompletos aunque el host todavía encienda.
Diagnóstico
Fuentes técnicas primarias y sus límites
Alcance documental — servidor fallas recurrentes diagnóstico: Para discos servidor fallas recurrentes diagnóstico, se consultan como fuentes primarias csrc.nist.gov. Evidencia física — servidor fallas recurrentes diagnóstico: Estas referencias delimitan preservación, estructura de almacenamiento y validación, pero no prueban el estado físico exacto, el controlador, la disponibilidad de llaves ni la consistencia operativa del equipo recibido. Evidencia del controlador — servidor fallas recurrentes diagnóstico: Esos puntos se determinan con mediciones del conjunto original y verificaciones sobre copias.
Diagnóstico
Solicitar una evaluación controlada
Conjunto completo — servidor fallas recurrentes diagnóstico: Para evaluar discos servidor fallas recurrentes diagnóstico, entregue el equipo o conjunto completo, alimentación e interfaces relacionadas, orden y etiquetas de los miembros, cronología de síntomas y una lista precisa de archivos prioritarios. Historial del incidente — servidor fallas recurrentes diagnóstico: Las credenciales autorizadas se comparten por un canal protegido independiente; evite otro encendido solo para generar una captura.
Responsabilidad del laboratorio — servidor fallas recurrentes diagnóstico: Datastrophe realiza directamente el diagnóstico, las verificaciones de integridad y la recuperación en su propio laboratorio con personal propio. Diagnóstico gratuito — servidor fallas recurrentes diagnóstico: El diagnóstico y la cotización son gratuitos. Límite del transporte — servidor fallas recurrentes diagnóstico: El envío privado de ida y vuelta está incluido; la transportista únicamente mueve el paquete sellado y no accede ni procesa los datos.
Lista controlada — servidor fallas recurrentes diagnóstico: Antes de cualquier pago, el cliente recibe el precio propuesto y una lista verificada. Clases de verificación — servidor fallas recurrentes diagnóstico: Cada elemento se clasifica, en orden, como recoverable_verified, partial, detected_unverified o unrecoverable. Momento del pago — servidor fallas recurrentes diagnóstico: Solo los elementos recoverable_verified, abiertos y comprobados como utilizables, se presentan como recuperables. Resultado no verificado — servidor fallas recurrentes diagnóstico: El pago se solicita después de aceptar la lista y el precio.
Resultado no verificado — servidor fallas recurrentes diagnóstico: Si no se verifica información utilizable, la recuperación falla o el cliente rechaza la lista o la cotización, no se genera un cargo estándar. Pieza excepcional — servidor fallas recurrentes diagnóstico: La única excepción es una pieza rara, costosa y no reembolsable, que requiere una propuesta separada, explícita y con precio aceptado.