
Diagnóstico
La carga convierte una falla simple en un incidente crítico
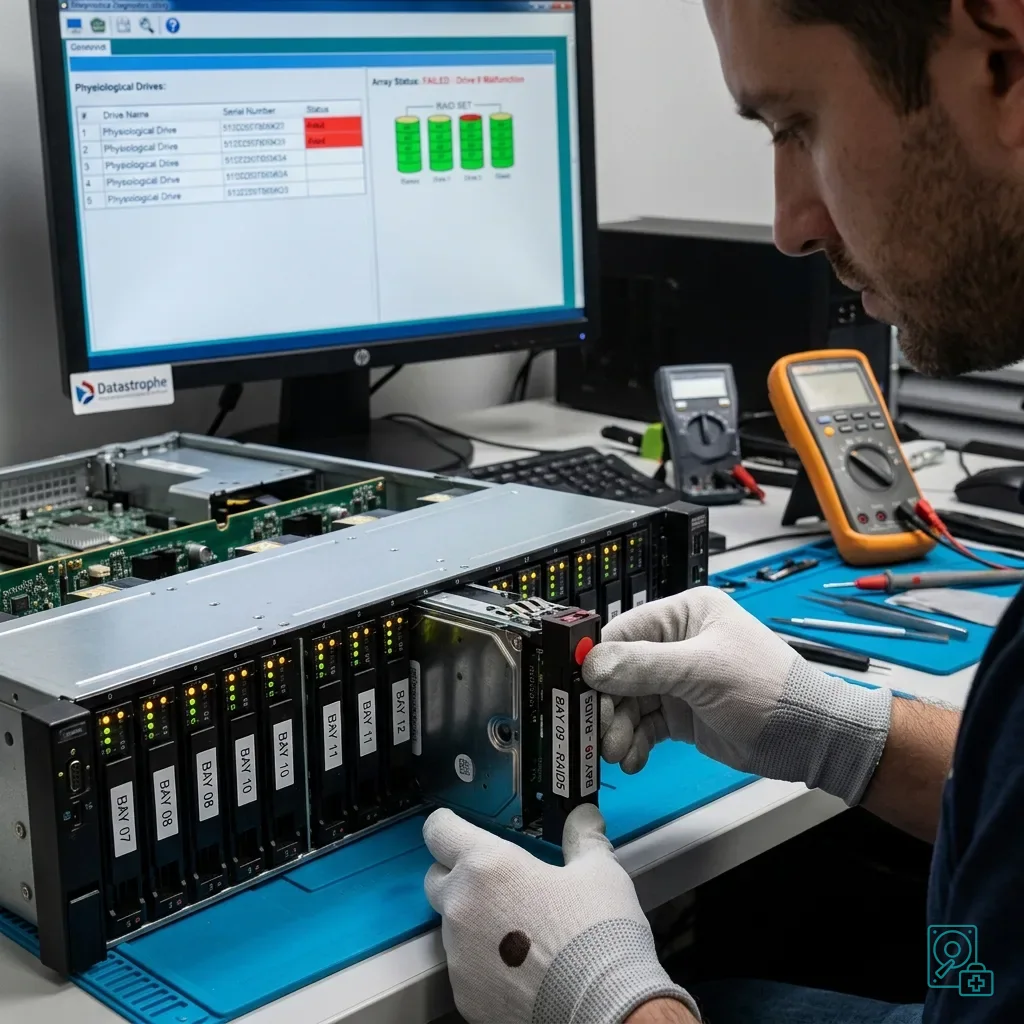
La carga cotidiana puede parecer estable hasta que una unidad del RAID de servidor falla. Al sumar una reconstrucción cambian simultáneamente el ritmo de lectura, la temperatura y el margen de error de todos los miembros.
La presión adicional revela sectores débiles, problemas de energía, conexiones inestables en el backplane, límites de la controladora o un volumen casi lleno. Lo que parecía la falla aislada de un disco puede ser el primer síntoma visible de una causa compartida.
Latencias anómalas, errores de E/S, una reconstrucción que se detiene o avanza a tirones y otra unidad que abandona el grupo son señales de alarma. Reiniciar para recuperar rendimiento no aclara su origen y puede alterar los registros que permitirían reconstruir la secuencia.
La recuperación de datos en sistemas RAID ofrece el marco de intervención cuando la disponibilidad y la integridad ya no pueden evaluarse desde el propio servidor. El diagnóstico debe abarcar tanto los discos como el sistema que los gobierna.
Antes de aumentar la actividad conviene preservar el estado, exportar los registros y decidir qué información es irremplazable. Una copia controlada de los miembros más frágiles puede ser más prudente que forzar una reconstrucción completa en el equipo original.
También importa el calendario del negocio. Un cierre contable, una sincronización masiva, un respaldo o una ventana de mantenimiento pueden coincidir con el incidente y explicar el pico de carga; detenerlos de forma coordinada reduce presión sin perder contexto.
Diagnóstico
La reconstrucción multiplica las lecturas y las escrituras
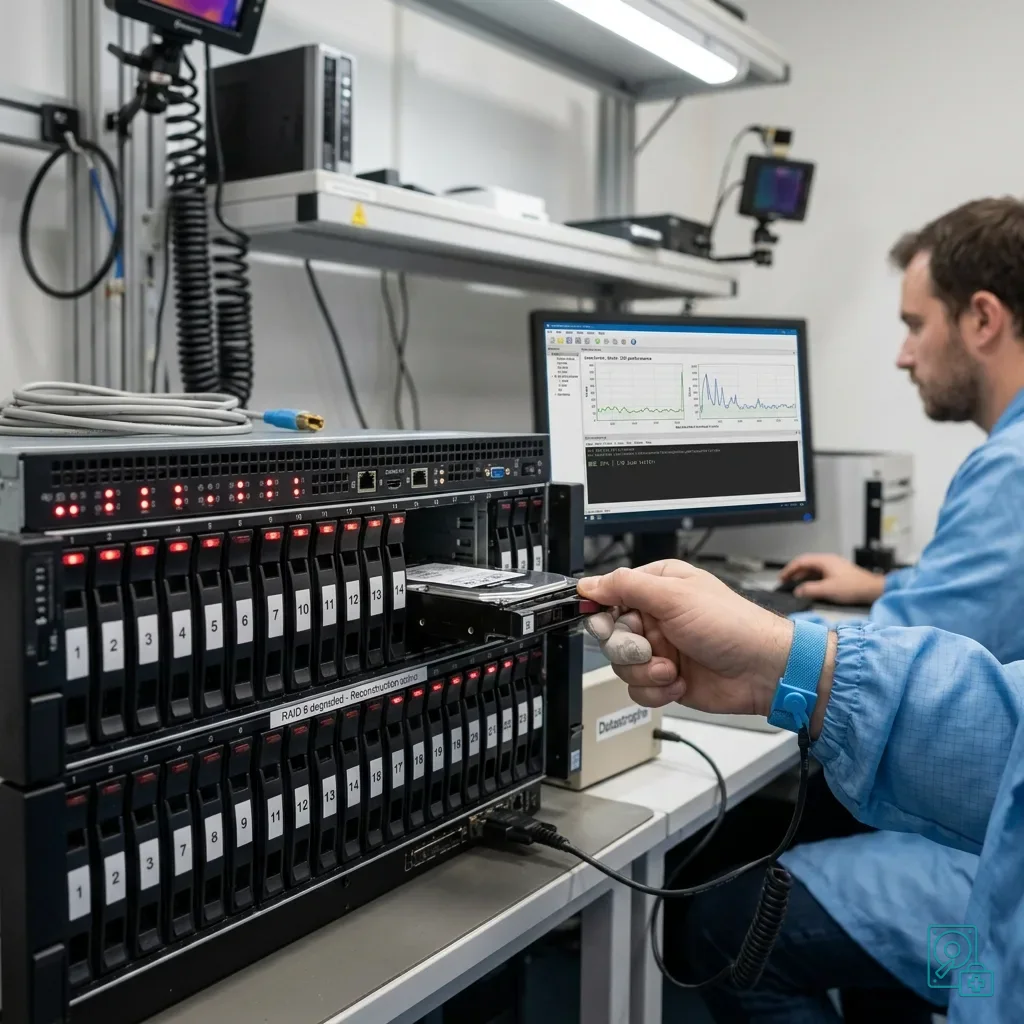
Reconstruir obliga a leer extensamente los discos supervivientes y a escribir el miembro de reemplazo. Al mismo tiempo pueden seguir activas bases de datos, máquinas virtuales, copias, antivirus, indexadores y usuarios, de modo que varias cargas compiten por los mismos recursos.
Una unidad que funcionaba con unos pocos sectores lentos puede fallar al recorrer casi toda su superficie. En RAID 5, RAID 6 o conjuntos anidados, la consecuencia depende del nivel, de las unidades ya excluidas y de si las demás respuestas siguen siendo coherentes.
Antes de decidir se contrastan SMART, alertas de la controladora, registro del sistema, eventos del hipervisor y mensajes de las aplicaciones. Ninguna fuente aislada basta, pero su cronología permite distinguir desgaste, desconexión, error lógico y saturación.
Las fallas repetidas de discos en un servidor pueden apuntar a un componente común y no a una mala serie de unidades. Reemplazar discos sucesivamente sin verificar esa hipótesis expone cada reemplazo a la misma condición.
Según el estado, puede ser necesario reducir la carga, congelar las aplicaciones, obtener imágenes de los discos o extraer primero los datos prioritarios. La reconstrucción solo se plantea después, sobre una base documentada y con una vía de retorno.
Diagnóstico
Incluir la controladora, el backplane y la energía
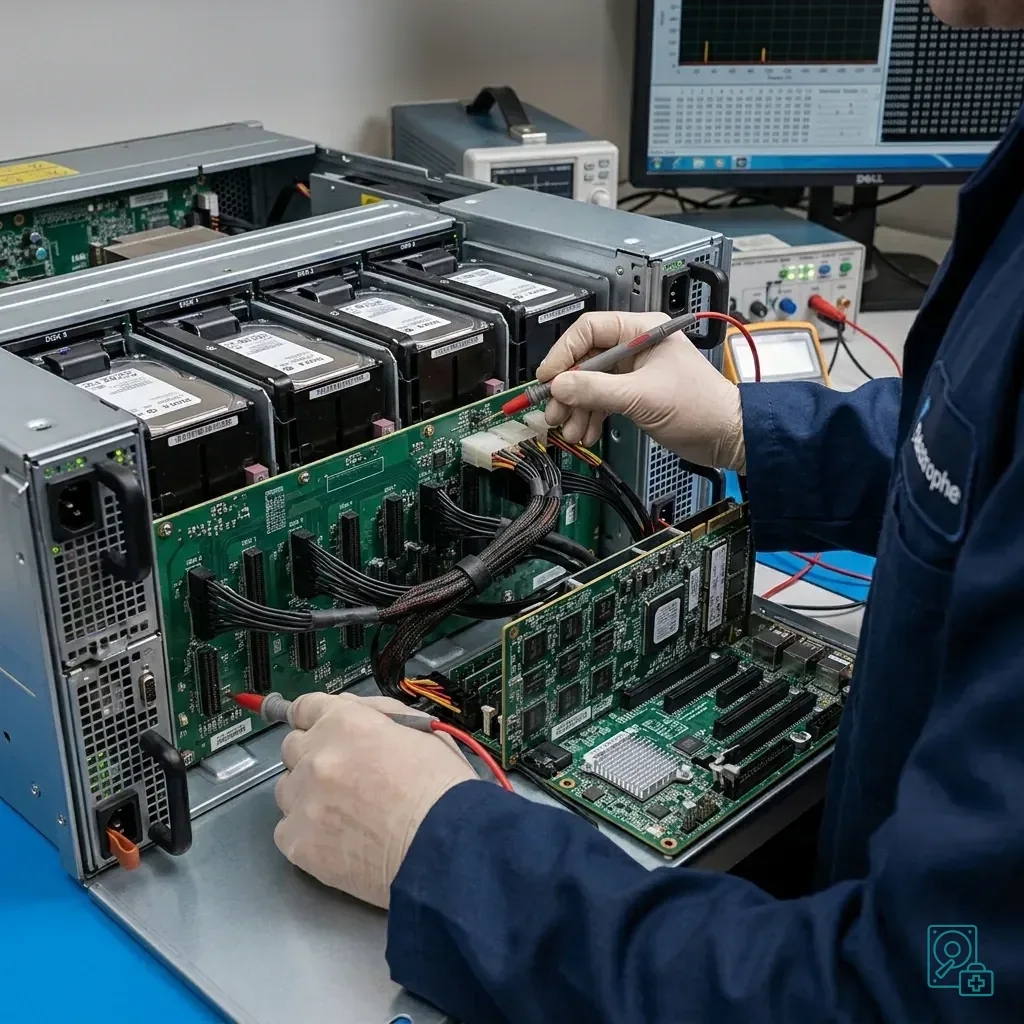
El diagnóstico no termina en los discos. Controladora RAID, caché, batería o condensador de respaldo, backplane, cables, fuentes y ventilación forman una cadena; un fallo intermitente en cualquiera de ellos puede expulsar unidades sanas o corromper escrituras.
El backplane suele pasar inadvertido porque todos los discos aparecen en la misma interfaz. Un conector fatigado, una línea compartida o una bahía concreta puede provocar errores que cambian de unidad cuando se intercambian posiciones, por lo que el orden original debe fotografiarse antes de tocar nada.
En un rack denso, el calor y una energía próxima a su límite empeoran durante la reconstrucción. Conviene correlacionar temperaturas, ventiladores, consumo y alertas con la hora exacta de las pérdidas de enlace, sin usar una nueva prueba de estrés sobre los datos originales.
Los límites de la redundancia RAID explican por qué tolerar la caída prevista de un miembro no protege frente a una causa común, una configuración errónea o varias unidades debilitadas al mismo tiempo.
La revisión debe unir la capa física con la lógica: nivel RAID, tamaño de banda, orden, metadatos, estado de cada miembro, registros, historial de reemplazos y reconstrucciones. Separar ambas capas demasiado pronto conduce a un diagnóstico incompleto.
Diagnóstico
Priorizar antes de volver a montar el volumen
No todos los datos exigen la misma urgencia. Bases de datos, máquinas virtuales, expedientes de clientes, correo, archivos de producción y archivos históricos deben ordenarse según impacto, disponibilidad de copias y dificultad de validación.
La continuidad del servicio se trata por separado de la preservación de los originales. Levantar una instancia temporal desde una copia verificada puede resolver la operación diaria sin convertir el RAID afectado en el lugar de reparación.
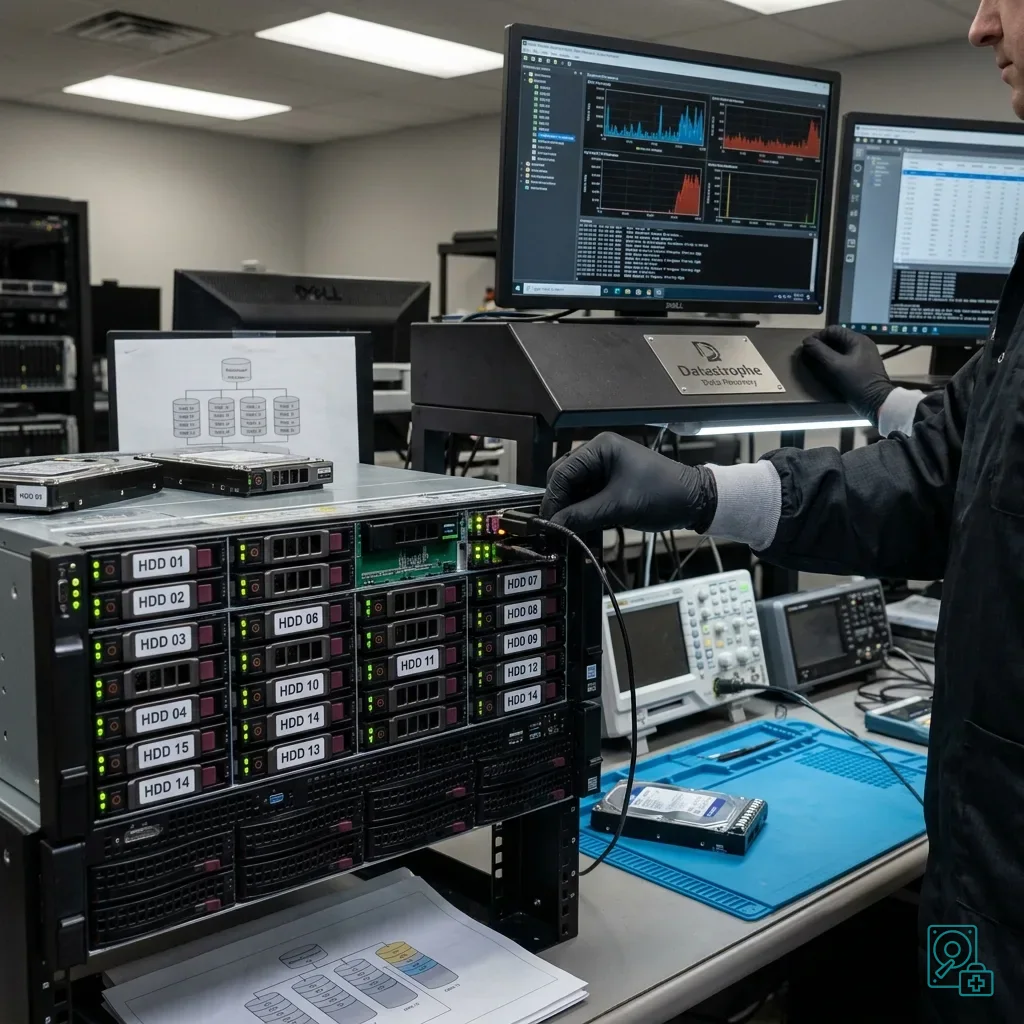
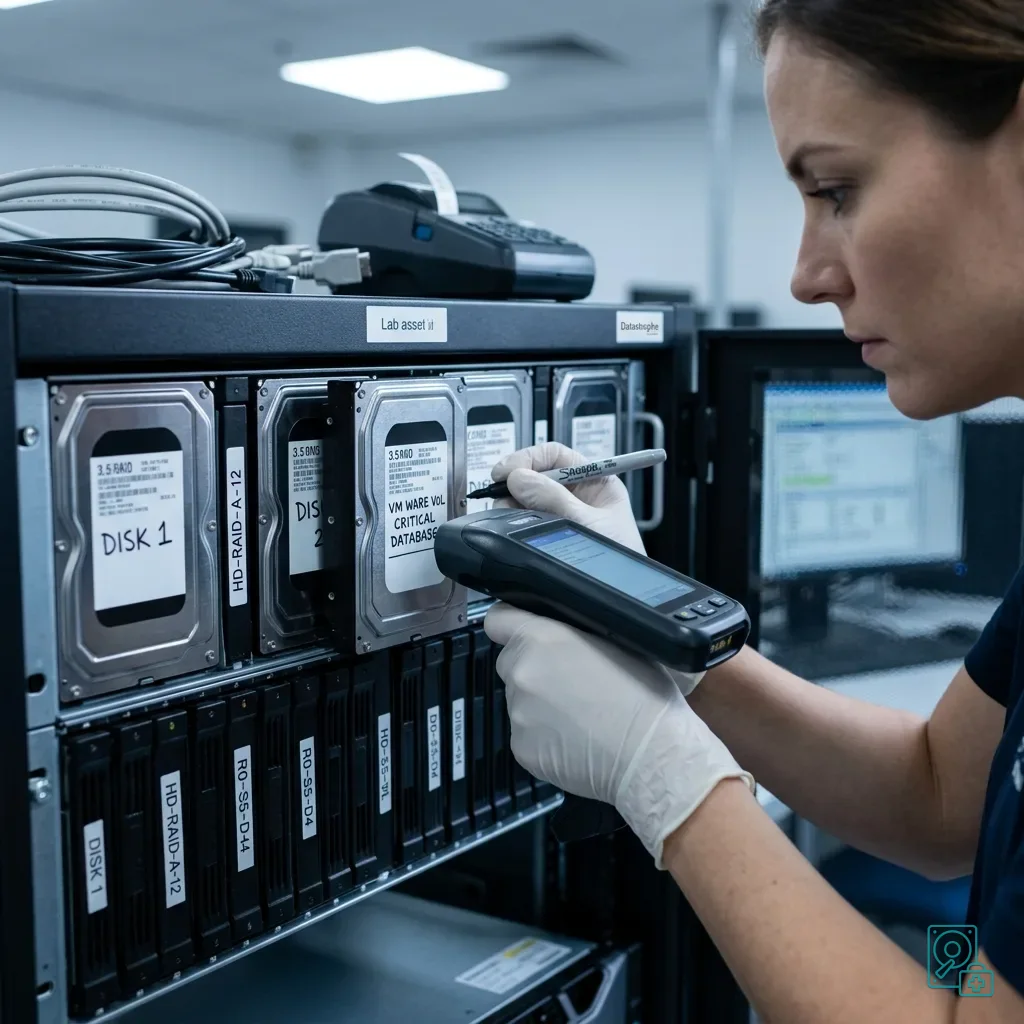
Se documentan posición y número de serie de cada disco, porcentaje y mensajes de la reconstrucción, reinicios, cambios de hardware, tareas activas y copias disponibles. Este inventario evita que una segunda persona repita una acción o interprete mal el estado.
Cuando un servidor contiene datos críticos, la prioridad debe expresarse en carpetas, volúmenes, VM, bases y fechas concretas. Una petición precisa permite verificar primero lo que realmente condiciona la actividad.
Que el volumen vuelva a mostrarse en línea no demuestra que esté sano. Hay que validar sistemas de archivos, archivos esenciales, consistencia de bases, arranque de VM y fechas; los datos visibles pero truncados no equivalen a una recuperación completa.
Diagnóstico
Preparar una intervención controlada
Para estudiar el incidente se reúnen modelo del servidor y de la controladora, nivel RAID, número y orden de discos, reemplazos, registros, alertas y prioridades. También se indica cuándo comenzó cada síntoma y qué acciones se realizaron después.
No conviene mezclar unidades, inicializarlas ni probarlas una por una en otro sistema sin conservar posición y configuración. Algunas controladoras escriben metadatos al importar o aceptar un disco, y esa modificación puede complicar la reconstrucción lógica posterior.
Si parte del servicio debe seguir disponible, hay que decirlo antes de intervenir. Así se puede acordar qué carga detener, qué réplica usar y qué datos capturar primero, en lugar de improvisar mientras cambia el conjunto.
Datastrophe prioriza la recuperación de los datos frente al mero reinicio inmediato del servidor. El objetivo es trabajar sobre copias cuando sea posible, mantener intactas las fuentes y justificar cada operación susceptible de escribir.
La prevención posterior combina copias probadas, alertas revisadas, configuración exportada, ventilación suficiente y un procedimiento para fallos de disco. La redundancia aporta continuidad, pero no sustituye una restauración ensayada ni un historial técnico.
En entornos virtualizados se verifican además datastores, discos virtuales, snapshots y dependencias entre VM. Un archivo recuperado puede tener el tamaño esperado y seguir siendo incoherente; abrirlo o arrancarlo en un entorno aislado forma parte de la validación.
Diagnóstico
Fuentes técnicas primarias y sus límites
Alcance documental — reconstrucción RAID servidor bajo carga: Para riesgos reconstrucción RAID servidor bajo carga, se consultan como fuentes primarias Linux MD administration guide. Evidencia física — reconstrucción RAID servidor bajo carga: Estas referencias delimitan preservación, estructura de almacenamiento y validación, pero no prueban el estado físico exacto, el controlador, la disponibilidad de llaves ni la consistencia operativa del equipo recibido. Evidencia del controlador — reconstrucción RAID servidor bajo carga: Esos puntos se determinan con mediciones del conjunto original y verificaciones sobre copias.
Diagnóstico
Solicitar una evaluación controlada
Conjunto completo — reconstrucción RAID servidor bajo carga: Para evaluar riesgos reconstrucción RAID servidor bajo carga, entregue el equipo o conjunto completo, alimentación e interfaces relacionadas, orden y etiquetas de los miembros, cronología de síntomas y una lista precisa de archivos prioritarios. Historial del incidente — reconstrucción RAID servidor bajo carga: Las credenciales autorizadas se comparten por un canal protegido independiente; evite otro encendido solo para generar una captura.
Responsabilidad del laboratorio — reconstrucción RAID servidor bajo carga: Datastrophe realiza directamente el diagnóstico, las verificaciones de integridad y la recuperación en su propio laboratorio con personal propio. Diagnóstico gratuito — reconstrucción RAID servidor bajo carga: El diagnóstico y la cotización son gratuitos. Límite del transporte — reconstrucción RAID servidor bajo carga: El envío privado de ida y vuelta está incluido; la transportista únicamente mueve el paquete sellado y no accede ni procesa los datos.
Lista controlada — reconstrucción RAID servidor bajo carga: Antes de cualquier pago, el cliente recibe el precio propuesto y una lista verificada. Clases de verificación — reconstrucción RAID servidor bajo carga: Cada elemento se clasifica, en orden, como recoverable_verified, partial, detected_unverified o unrecoverable. Momento del pago — reconstrucción RAID servidor bajo carga: Solo los elementos recoverable_verified, abiertos y comprobados como utilizables, se presentan como recuperables. Resultado no verificado — reconstrucción RAID servidor bajo carga: El pago se solicita después de aceptar la lista y el precio.
Resultado no verificado — reconstrucción RAID servidor bajo carga: Si no se verifica información utilizable, la recuperación falla o el cliente rechaza la lista o la cotización, no se genera un cargo estándar. Pieza excepcional — reconstrucción RAID servidor bajo carga: La única excepción es una pieza rara, costosa y no reembolsable, que requiere una propuesta separada, explícita y con precio aceptado.