
Diagnose
Workload kan een eenvoudige fout kritiek maken
Een server-RAID kan stabiel lijken zolang de workload normaal blijft. Wanneer een member faalt en reconstructie begint, verandert het evenwicht: overlevende disks lezen meer, de controller schrijft voortdurend, toepassingen blijven het volume mogelijk gebruiken en back-upverkeer verhoogt de druk.
Die combinatie verklaart waarom een array onder belasting kan falen. De vervangende disk is zelden het hele verhaal, want reconstructie legt vaak bestaande zwakke sectoren, hitte, marginale voeding, een onderbroken backplane, controllerfouten of een bijna vol volume bloot.
Vroege signalen kunnen misleiden. De server draait nog, maar responstijden stijgen, I/O-fouten verschijnen in logs, rebuildvoortgang stopt of nog een member verlaat de groep. Behandel elk als ernstige waarschuwing en niet als gewone vertraging.
De dienst dataherstel voor RAID-systemen beschrijft het behandelingsproces. Hier gaat het om de kwetsbare periode waarin reconstructie en actieve serverworkload om dezelfde opslag concurreren.
Bewaar de toestand vóór u nog een bewerking toevoegt. Een geforceerde rebuild, restore naar dezelfde plaats of ongedocumenteerde herstart kan membermetadata wijzigen en het latere herstelpad onzekerder maken.
Ook de bedrijfstiming telt. Reconstructie tijdens een financiële afsluiting, massale synchronisatie of back-upvenster ontmoet een heel ander I/O-profiel dan in een rustige periode. Planning beïnvloedt het risico even sterk als de opdracht.
Diagnose
Rebuilds verhogen reads en writes
RAID-reconstructie is geen neutrale achtergrondtaak. Ze leest overlevende members, berekent vervangende blokken en schrijft een nieuwe disk terwijl toepassingrequests, back-uptaken, scans en virtuele machines dezelfde controller en spindels kunnen blijven gebruiken.
Heeft een andere member al zwakke sectoren, dan kan langdurig uitlezen hem voorbij herstel duwen. De server kan van een gedegradeerd maar bereikbaar volume naar een incoherente of ontoegankelijke toestand gaan, vooral wanneer disks leeftijd en bedrijfsomstandigheden delen.
Beoordeel membergezondheid vóór onbeperkte voortgang. Logs van SMART, RAID-controller, besturingssysteem en hypervisor kunnen aantonen of het risico bij één disk blijft of doorheen het chassis loopt.
De gids over diagnose van herhaalde serverschijfdefecten geeft extra context. Kort opeenvolgende fouten en moeilijke rebuilds zijn een systeemprobleem en niet alleen een wachtrij van te vervangen members.
Soms is het veiliger eerst de workload te verminderen, configuratie te bevriezen en bronnen te imagen. RAID-niveau, aantal instabiele disks, datawaarde en operationele dringendheid bepalen die beslissing.
Diagnose
Neem controller backplane en voeding mee
Een server-RAID steunt ook op gedeelde componenten. Controller, backplane, kabels, stroom en koeling kunnen fouten over verschillende disks veroorzaken. Eén member vervangen lost geen incident in gedeelde infrastructuur op.
Backplanes worden vaak vergeten. Een onderbroken sleuf kan contact verliezen of fouten genereren die op mediaschade lijken. Die instabiliteit wordt bijzonder gevaarlijk wanneer reconstructie herhaaldelijk elke member doorloopt.
Hitte en stroom verdienen dezelfde aandacht. Een dicht rack, beperkte luchtstroom of zwaar belaste voeding kan fouten tijdens piekactiviteit vermenigvuldigen, precies wanneer de RAID de hoogste langdurige prestaties vraagt.
Het artikel over RAID-redundantie en haar grenzen benadrukt een kernpunt: redundantie is geen back-up en beschermt niet tegen een gedeelde oorzaak, menselijke fout of verkeerd gestarte rebuild.
De diagnose omvat dus hardware en logische lagen. RAID-niveau, membervolgorde, metadata, logs en vervangingshistoriek zijn allemaal nodig om te bepalen welke bronstatus nog kan worden bewaard.
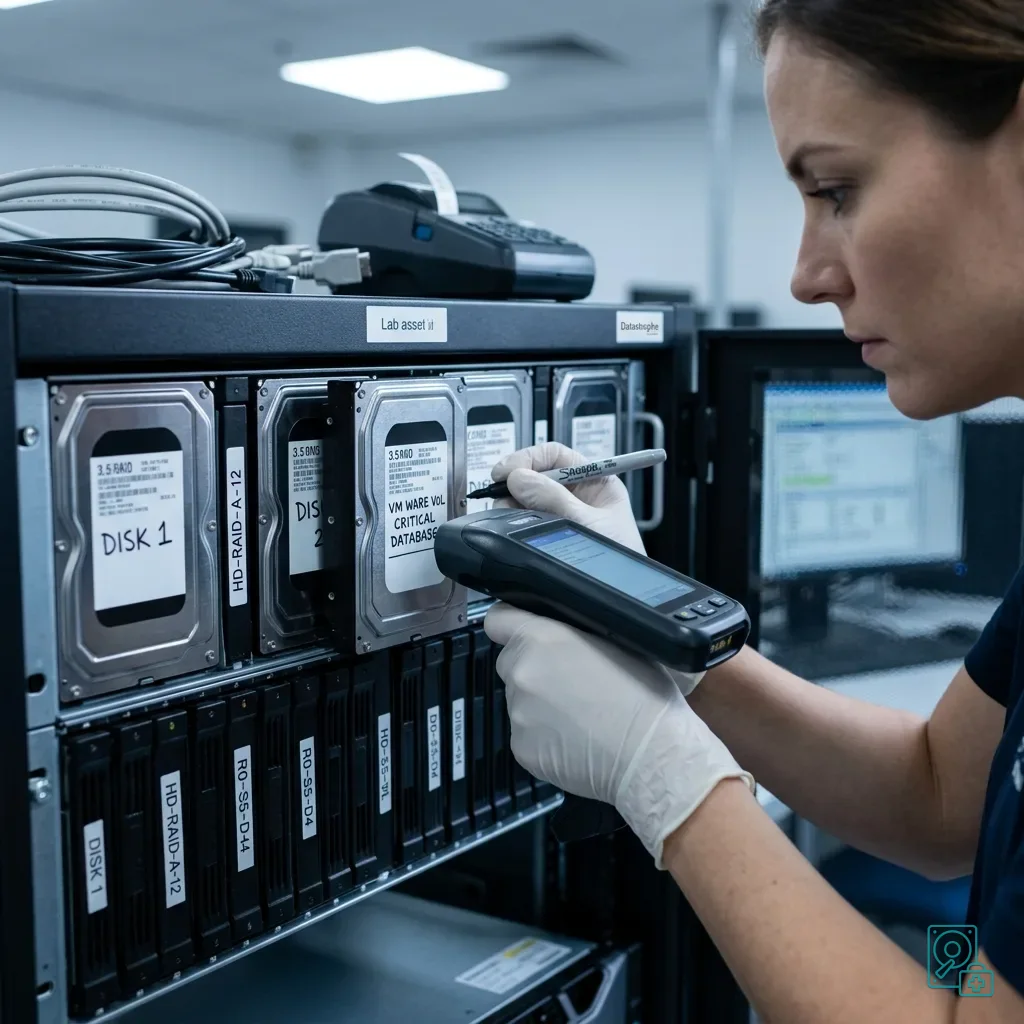
Diagnose
Bepaal prioriteiten vóór het volume terugkeert
Rangschik kritieke serverinformatie expliciet. Een bedrijfsdatabank, virtuele machines, klantmappen, e-mail, productietoepassingen en archieven hebben een verschillende dringendheid. Technische reconstructie mag hun werkelijke waarde niet verhullen.
De dienst kan soms vanaf een aparte back-up of kopie hervatten terwijl oorspronkelijke members voor onderzoek beschikbaar blijven. Restoren naar de verkeerde bestemming of de groep resetten kan precies het bewijs wissen dat nog nodig is.
Registreer elke eerdere poging: vervangen disk en sleuf, start van de rebuild, bereikt percentage, weergegeven meldingen, herstarts en geactiveerde back-uptaken. Die chronologie voorkomt dezelfde riskante bewerking onder een andere naam.
Het artikel over verlies van kritieke serverdata onderzoekt bedrijfsprioriteiten. Op een drukke RAID helpt die rangorde kiezen tussen snelle failover, technische acquisitie en gecontroleerde reconstructie.
Noem een volume dat opnieuw online komt niet meteen gezond. Controleer prioritaire bestanden, databanken en virtuele machines vóór u besluit dat het incident en zijn logische gevolgen voorbij zijn.
Diagnose
Bereid een gecontroleerde interventie voor
Nuttige voorbereiding is concreet: server- en controllermodellen, RAID-niveau, aantal members, exacte volgorde, vervangen disks, waarschuwingen, logs en prioritaire bestanden. Volledige feiten beperken aannames terwijl bronnen kwetsbaar blijven.
Meng members niet en test ze niet afzonderlijk zonder traceerbaar register. Omkering, initialisatie of geforceerde import kan metadata wijzigen die later nodig is om het logische volume te assembleren.
Wanneer gedeeltelijke serverbeschikbaarheid verplicht is, benoem die beperking. Sommige dossiers laten aparte continuïteitsoplossingen toe terwijl de bronset beschermd blijft; in andere biedt gecontroleerd uitschakelen het laagste datarisico.
Datastrophe kan een belaste server-RAID beoordelen met datawaarde boven onmiddellijke hardwareherstart. Het doel is memberuitval, gedeelde oorzaak, logische corruptie en realistische herstellimieten te scheiden.
Houd preventie na het incident eenvoudig: geteste back-ups, opgevolgde waarschuwingen, gedocumenteerde RAID-configuratie, voldoende koeling en een gekende rebuildprocedure. Samen voorkomen ze dat één componentfout een volledige servicecrisis wordt.
Wanneer de RAID virtuele machines host, neem dan VM-bestanden, snapshots en datastores in aanvaardingstests op. Voltooiing door de controller bewijst geen coherente guest wanneer toepassingwrites tijdens reconstructie zijn onderbroken.
Diagnose
Primaire technische bronnen en beperkingen
Bronnenkader — onder belasting risico rebuild: Voor server-RAID onder belasting risico rebuild worden Linux MD administration guide als primaire bronnen gebruikt. Fysiek bewijs — onder belasting risico rebuild: Ze beschrijven de relevante principes voor bewaring, opslagstructuur en validatie, maar bewijzen niet de precieze fysieke toestand, het gedrag van de controller, de beschikbaarheid van sleutels of de functionele samenhang van het ontvangen toestel. Controllerbewijs — onder belasting risico rebuild: Daarvoor zijn metingen op de oorspronkelijke set en controles op kopieën nodig.
Diagnose
Een gecontroleerde diagnose aanvragen
Volledige set — onder belasting risico rebuild: Bezorg voor de diagnose van server-RAID onder belasting risico rebuild het volledige toestel of de volledige set, bijbehorende voeding en interfaces, volgorde en labels van de leden, het verloop van de symptomen en een precieze lijst met prioritaire gegevens. Incidentverloop — onder belasting risico rebuild: Verstuur toegestane toegangsgegevens via een apart beveiligd kanaal en start de bron niet opnieuw op enkel voor een nieuwe schermafbeelding.
Verantwoordelijkheid van het laboratorium — onder belasting risico rebuild: Datastrophe voert diagnose, integriteitscontroles en gegevensherstel rechtstreeks uit in het eigen laboratorium en met het eigen team. Gratis diagnose — onder belasting risico rebuild: Diagnose en offerte zijn gratis. Transportgrens — onder belasting risico rebuild: Privévervoer heen en terug is inbegrepen; de vervoerder verplaatst uitsluitend het verzegelde pakket en krijgt geen toegang tot de gegevens.
Gecontroleerde lijst — onder belasting risico rebuild: Vóór enige betaling ontvangt de klant de voorgestelde prijs en een gecontroleerde lijst. Verificatieklassen — onder belasting risico rebuild: Elk element wordt in deze volgorde ingedeeld als recoverable_verified, partial, detected_unverified of unrecoverable. Betalingsmoment — onder belasting risico rebuild: Alleen geopende en bruikbaar bevonden elementen met de status recoverable_verified worden als herstelbaar voorgesteld. Niet-bevestigd resultaat — onder belasting risico rebuild: Betaling volgt pas na aanvaarding van lijst en prijs.
Niet-bevestigd resultaat — onder belasting risico rebuild: Wanneer geen bruikbare gegevens worden bevestigd, het herstel mislukt of de klant lijst of prijs weigert, zijn geen standaardkosten verschuldigd. Uitzonderlijk onderdeel — onder belasting risico rebuild: De enige uitzondering is een zeldzaam, duur en niet-terugbetaalbaar onderdeel, dat uitsluitend na aanvaarding van een afzonderlijk, uitdrukkelijk en geprijsd voorstel mag worden besteld.