
Diagnose
Terugkerende storingen hebben vaak één oorzaak
Wanneer één serverschijf een fout meldt, lijkt vervangen de logische reactie. Verschijnen verschillende waarschuwingen kort na elkaar, dan moet de diagnose breder worden: hitte, voeding, backplane, RAID-controller, trillingen, firmware of een zware rebuild kan alle schijven beïnvloeden. Behandel de reeks als één incident tot het tegendeel bewezen is.
Een server bundelt veel afhankelijkheden. Schijven draaien doorgaans continu in dezelfde behuizing, delen koeling, stroom en verbindingen en worden op vergelijkbare momenten zwaar belast. Meerdere defecten zijn daarom niet noodzakelijk een toevallige opeenvolging van losstaande schijfproblemen.
Lees de signalen samen: SMART-fouten, herverdeelde sectoren, schijven die verdwijnen, trage I/O, een vastlopende rebuild, gedegradeerde volumes en waarschuwingen over ventilatoren of voeding. Noteer voor elk voorval datum, sleuf, serienummer, firmware en belasting. Een patroon over tijd is informatiever dan één alarmscherm.
Dataherstel van servers benadert gegevens en infrastructuur als onderdelen van dezelfde storing. De technische diagnose moet verklaren waarom fouten terugkomen, terwijl de resterende bronnen zo weinig mogelijk worden belast. Bewaar daarom logs vóór rotatie, reset of een nieuwe vervangingspoging.
Het grootste risico is schijf na schijf vervangen zonder de gemeenschappelijke oorzaak te vinden. Elke rebuild leest de overblijvende leden langdurig en intensief. Als een tweede schijf zwakke sectoren of mechanische problemen heeft, kan net die extra belasting de fouttolerantie volledig doorbreken.
Wees ook voorzichtig wanneer een waarschuwing na een herstart verdwijnt. Een schijf die opnieuw online komt, bewijst niet dat de storing voorbij is; een instabiele connector, lastige sleuf of voeding op de limiet veroorzaakt vaak intermitterende fouten. Rangschik tegelijk de kritieke servergegevens en controleer welke back-ups inhoudelijk herstelbaar zijn.
Diagnose
Controleer RAID, backplane en voeding
RAID kan een schijfuitval tijdelijk opvangen, maar herstelt geen defect in de gedeelde infrastructuur. Een instabiele controller, beschadigde backplane of onregelmatige voeding kan op verschillende leden fouten veroorzaken. Alleen de datadragers vervangen laat die oorzaak bestaan en lokt mogelijk een nieuwe storingsreeks uit.
De backplane verdient afzonderlijke aandacht. Versleten contacten, oxidatie, een slecht geplaatste schijf of een defecte bay kan de verbinding af en toe verbreken. Volgt de fout telkens dezelfde sleuf in plaats van hetzelfde serienummer, dan wijst dat eerder naar connector, kanaal of backplane dan naar toevallig falende disks.
Ook warmte en stroom moeten met de tijdlijn worden vergeleken. Een slecht geventileerd rack, stof, defecte ventilator of hoge omgevingstemperatuur laat de zwaarst belaste schijven eerst fouten tonen. Spanningsschommelingen kunnen verschillende leden tegelijk verzwakken, ook wanneer hun alarmen pas na elkaar verschijnen.
Trillingen en werklast vergroten de mechanische belasting, vooral tijdens een lange reconstructie met schijven van dezelfde leeftijd. Controllerfirmware, cache, kabels en poorten kunnen bovendien resets registreren alsof de disk zelf verdween. Leg RAID-niveau, stripe, cachemodus, hotspares en huidige lidstatus vast vóór verdere tests.
De grenzen van RAID-redundantie maken duidelijk dat een beschikbaar volume geen back-up of integriteitsbewijs vormt. Een gemounte array kan reeds inconsistente bestanden bevatten. Vergelijk daarom ruwe schijffouten met wat controller, host en monitoring op hetzelfde tijdstip hebben waargenomen.
Bewaar controller-, systeem-, hypervisor-, SMART- en bewakingslogs voordat oudere regels automatisch verdwijnen. Ze tonen welke schijf eerst meldde, wanneer een rebuild begon en welke bay contact verloor. Zo kunt u een werkelijk defect lid onderscheiden van een gezonde schijf die op een slecht moment werd losgekoppeld.
Diagnose
Vermijd een eindeloze rebuildcyclus
Een RAID-rebuild is nuttig wanneer de context gezond en stabiel is. Ze wordt riskant zodra meerdere leden traag zijn, klikken, onherstelbare leesfouten melden of de gemeenschappelijke oorzaak onbekend blijft. Herhaald reconstrueren kan de laatste leesbare sectoren uitputten en de oorspronkelijke metadata wijzigen.
Vermijd niet-gedocumenteerde automatische acties: opeenvolgende vervangingen, initialisatie, geforceerde import, wissen van een foreign configuration, volume-uitbreiding of restore op dezelfde plaats. Noteer exact welk serienummer uit welke sleuf kwam. Reset geen controllermetadata voordat configuratie en logs veilig zijn bewaard.
Bewaar vóór een reconstructie de schijfvolgorde, RAID-parameters, actuele lidstatus en volledige historiek. Zijn de gegevens kritiek en vertonen de leden instabiliteit, dan zijn gecontroleerde sectorimages met foutregistratie vaak veiliger dan nog een live rebuild. Laat de originele schijven daarna uitgeschakeld beschikbaar.
Voer geen afzonderlijke bestandssysteemreparaties uit op een gemount volume zolang geen consistente sectorbasis bestaat. Stop productiewrites, replicatie en andere zware taken die de array blijven aanspreken. Een scanprogramma kan logische structuren wijzigen terwijl de fysieke oorzaak nog altijd actief is.
Verwar een opnieuw gemount volume niet met een betrouwbaar resultaat. Een server kan na een rebuild opstarten en toch corrupte documenten, ontbrekende VM-blokken of een beschadigde databank bevatten. De technische reconstructie moet daarom altijd door een inhoudelijke kwaliteitscontrole worden gevolgd.
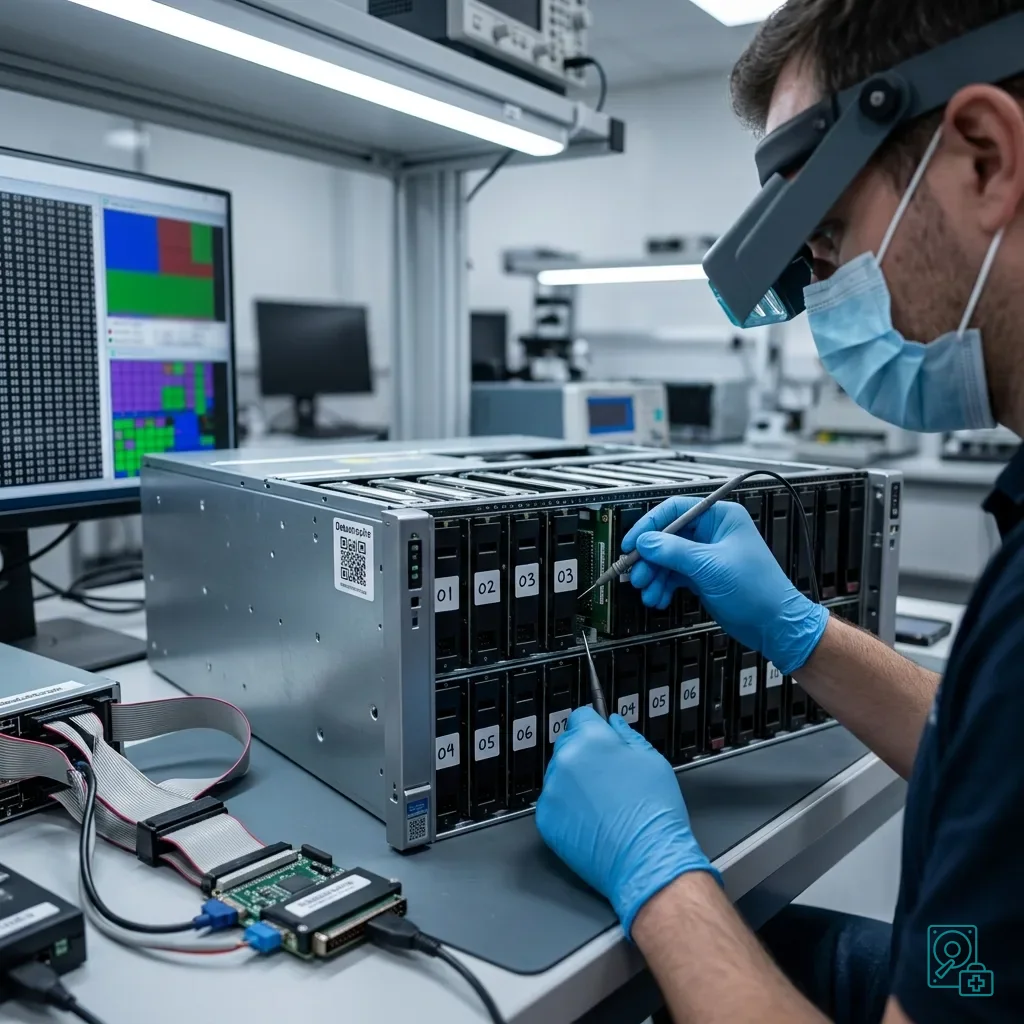
Diagnose
Geef prioriteit aan diensten en kritieke gegevens
Niet alle gegevens op een server hebben dezelfde waarde of afhankelijkheden. Een bedrijfsdatabank, gedeelde map, lokale mailomgeving, productiebestand of datastore met virtuele machines vraagt een andere volgorde. Leg vóór de analyse vast welke diensten eerst bruikbare gegevens moeten opleveren.
De werking kan tijdelijk hervatten op een kopie of geteste back-up, maar die actie mag de bronnen niet overschrijven. Bewaar originele schijven, controllerconfiguratie en logs wanneer IT snel een restore uitvoert. Zo blijft later een grondige reconstructie mogelijk wanneer in de back-up toch gegevens ontbreken.
Neem toepassingsafhankelijkheden mee. Een databank zonder transactielogs, een virtuele machine zonder descriptor of een share zonder rechtenstructuur is slechts gedeeltelijk inzetbaar. Reconstrueer RAID-parameters op kopieën, test mogelijke layouts read-only en laat de gegevensverantwoordelijke de relevante tijdstoestand beoordelen.
Een bedrijfsplan voor dataherstel koppelt die technische keuzes aan vooraf bepaalde bedrijfsprioriteiten. Heldere informatie zoals "volume gedegradeerd, rebuild gestopt, schijven 2 en 4 instabiel, boekhoudgegevens prioritair" voorkomt tegenstrijdige acties beter dan een algemene melding dat de server defect is.
Datastrophe rapporteert per lid welke gegevens en fouten werden gelezen, welke RAID-layout werd gekozen en welke onzekerheden overblijven. Daarna worden volumes, databanken en bestanden inhoudelijk gecontroleerd. Zo steunt de teruggave op aantoonbare bruikbaarheid, niet alleen op een array die opnieuw online staat.
Diagnose
Documenteer de preventie
Na het incident moet de preventie teruggaan tot de werkelijke oorzaak. Waren hitte, voeding, backplane, bekabeling of firmware betrokken, dan volstaat een nieuwe set schijven niet. Controleer de hele omgeving, de bewaking, het back-upbeleid en de voorwaarden waaronder een rebuild automatisch mag starten.
Test alarmen en de reactie erop. Een SMART- of RAID-melding die dagen onbehandeld blijft, kan een eenvoudige uitval veranderen in een volledige storing. Monitor trends per sleuf en controller, niet alleen de algemene RAID-status, en leg vast wie bij elke ernstgraad moet handelen.
Back-ups moeten onafhankelijk, applicatieconsistent en aantoonbaar herstelbaar zijn. Een te oude of nooit geteste kopie in hetzelfde rack biedt weinig zekerheid tegen een gedeelde oorzaak. Voer restores uit buiten de productiearray en controleer kritieke databanken, VM's en bestanden in hun echte toepassing.
Onderhoud een serverfiche met model, controller, RAID-type, stripe, schijfvolgorde, capaciteit, firmware, locatie en gehoste diensten. Voeg sleuf- en vervangingshistoriek toe en plan vernieuwing zonder ongecontroleerd incompatibele modellen te mengen. Bij een storing voorkomt die informatie riskante proefondervindelijke acties.
Datastrophe kan servers onderzoeken waarvan meerdere schijven uitvallen of een reconstructie blijft mislukken. Het doel is waarschijnlijke oorzaken herkennen, de dragers stabiliseren en prioritaire gegevens terughalen zonder nutteloze destructieve bewerkingen opnieuw te starten. Alle beslissingen en stopcriteria worden daarbij vastgelegd.
In gevirtualiseerde omgevingen omvat de analyse ook datastores, VM-volumes, descriptors en snapshots. Een fysieke serverschijf kan onvolledige blokken in verscheidene virtuele disks veroorzaken, zelfs wanneer de host nog opstart. Controleer daarom ook de inhoud van elke kritieke virtuele dienst na de RAID-reconstructie.
Diagnose
Primaire technische bronnen en beperkingen
Bronnenkader — terugkerende storingen diagnose: Voor serverschijven terugkerende storingen diagnose worden csrc.nist.gov als primaire bronnen gebruikt. Fysiek bewijs — terugkerende storingen diagnose: Ze beschrijven de relevante principes voor bewaring, opslagstructuur en validatie, maar bewijzen niet de precieze fysieke toestand, het gedrag van de controller, de beschikbaarheid van sleutels of de functionele samenhang van het ontvangen toestel. Controllerbewijs — terugkerende storingen diagnose: Daarvoor zijn metingen op de oorspronkelijke set en controles op kopieën nodig.
Diagnose
Een gecontroleerde diagnose aanvragen
Volledige set — terugkerende storingen diagnose: Bezorg voor de diagnose van serverschijven terugkerende storingen diagnose het volledige toestel of de volledige set, bijbehorende voeding en interfaces, volgorde en labels van de leden, het verloop van de symptomen en een precieze lijst met prioritaire gegevens. Incidentverloop — terugkerende storingen diagnose: Verstuur toegestane toegangsgegevens via een apart beveiligd kanaal en start de bron niet opnieuw op enkel voor een nieuwe schermafbeelding.
Verantwoordelijkheid van het laboratorium — terugkerende storingen diagnose: Datastrophe voert diagnose, integriteitscontroles en gegevensherstel rechtstreeks uit in het eigen laboratorium en met het eigen team. Gratis diagnose — terugkerende storingen diagnose: Diagnose en offerte zijn gratis. Transportgrens — terugkerende storingen diagnose: Privévervoer heen en terug is inbegrepen; de vervoerder verplaatst uitsluitend het verzegelde pakket en krijgt geen toegang tot de gegevens.
Gecontroleerde lijst — terugkerende storingen diagnose: Vóór enige betaling ontvangt de klant de voorgestelde prijs en een gecontroleerde lijst. Verificatieklassen — terugkerende storingen diagnose: Elk element wordt in deze volgorde ingedeeld als recoverable_verified, partial, detected_unverified of unrecoverable. Betalingsmoment — terugkerende storingen diagnose: Alleen geopende en bruikbaar bevonden elementen met de status recoverable_verified worden als herstelbaar voorgesteld. Niet-bevestigd resultaat — terugkerende storingen diagnose: Betaling volgt pas na aanvaarding van lijst en prijs.
Niet-bevestigd resultaat — terugkerende storingen diagnose: Wanneer geen bruikbare gegevens worden bevestigd, het herstel mislukt of de klant lijst of prijs weigert, zijn geen standaardkosten verschuldigd. Uitzonderlijk onderdeel — terugkerende storingen diagnose: De enige uitzondering is een zeldzaam, duur en niet-terugbetaalbaar onderdeel, dat uitsluitend na aanvaarding van een afzonderlijk, uitdrukkelijk en geprijsd voorstel mag worden besteld.