
Diagnostic
Ne pas confondre disponibilité et récupération
Cluster, cloud, snapshots, sauvegarde et réplication peuvent maintenir un service disponible, mais aucun ne prouve à lui seul que les données sont récupérables. Un système peut redémarrer rapidement avec une base déjà incohérente ou des fichiers supprimés depuis plusieurs heures.
La virtualisation répartit le risque entre VMDK ou VHDX, hyperviseur, espace de stockage partagé, réseau, RAID, système invité et application. La panne devient visible dans la VM alors que son origine peut se situer sous le fichier virtuel ou au-dessus, dans une transaction métier.
Chaque mécanisme répond à une menace limitée. Un snapshot n'est pas autonome, une réplication reproduit l'état qu'elle reçoit et un stockage cloud reste exposé aux droits, aux suppressions et aux corruptions logiques. Leur présence n'équivaut pas à une sauvegarde vérifiée.
La page de récupération de disque virtuel décrit la prise en charge lorsque ces couches ne suffisent plus. Avant réparation, il faut préserver les états disponibles et comprendre quelles opérations ont déjà modifié chacun d'eux.
La version la plus récente peut contenir l'incident, tandis qu'une sauvegarde ou un snapshot plus ancien garde une structure cohérente. Les versions sont comparées par contenu et par application, pas sélectionnées uniquement sur leur date.
Ne nettoyez donc pas le dossier de la VM pour le rendre lisible. Deltas, journaux, descripteurs et copies partielles peuvent restituer la chronologie. Supprimer un fichier jugé ancien peut rompre la seule chaîne qui précède la perte.
Diagnostic
Traiter le snapshot comme une dépendance
Un snapshot enregistre les différences depuis un disque parent et dépend souvent de tous les maillons précédents. Si un fichier manque, si l'espace de stockage est saturé ou si un descripteur est incohérent, l'état ne peut pas être consolidé simplement parce qu'il apparaît dans l'interface.
Fusionner ou supprimer des snapshots écrit dans la chaîne. Cette opération peut intégrer la mauvaise version et effacer les deltas utiles au diagnostic. Elle doit être simulée sur une copie après inventaire des fichiers, jamais utilisée comme premier test.
Un snapshot pris après une suppression ou une corruption capture également cet incident. Revenir à l'état le plus proche n'est utile que si les fichiers et bases y sont cohérents. Plusieurs points de temps doivent être vérifiés sur un environnement isolé.
Les signes de panne d'un disque virtuel en cluster incluent snapshots bloqués, erreurs d'entrée-sortie et volumes incohérents. Ces alertes imposent de figer les écritures et de conserver les journaux du stockage et de l'hyperviseur.
Documentez ordre, noms, tailles, dates, parents, tâches de sauvegarde et messages exacts. Cette cartographie montre les dépendances et permet de reconstruire plusieurs hypothèses sans confondre un état natif avec une fusion produite pendant l'analyse.
Diagnostic
Vérifier ce que la réplication a copié
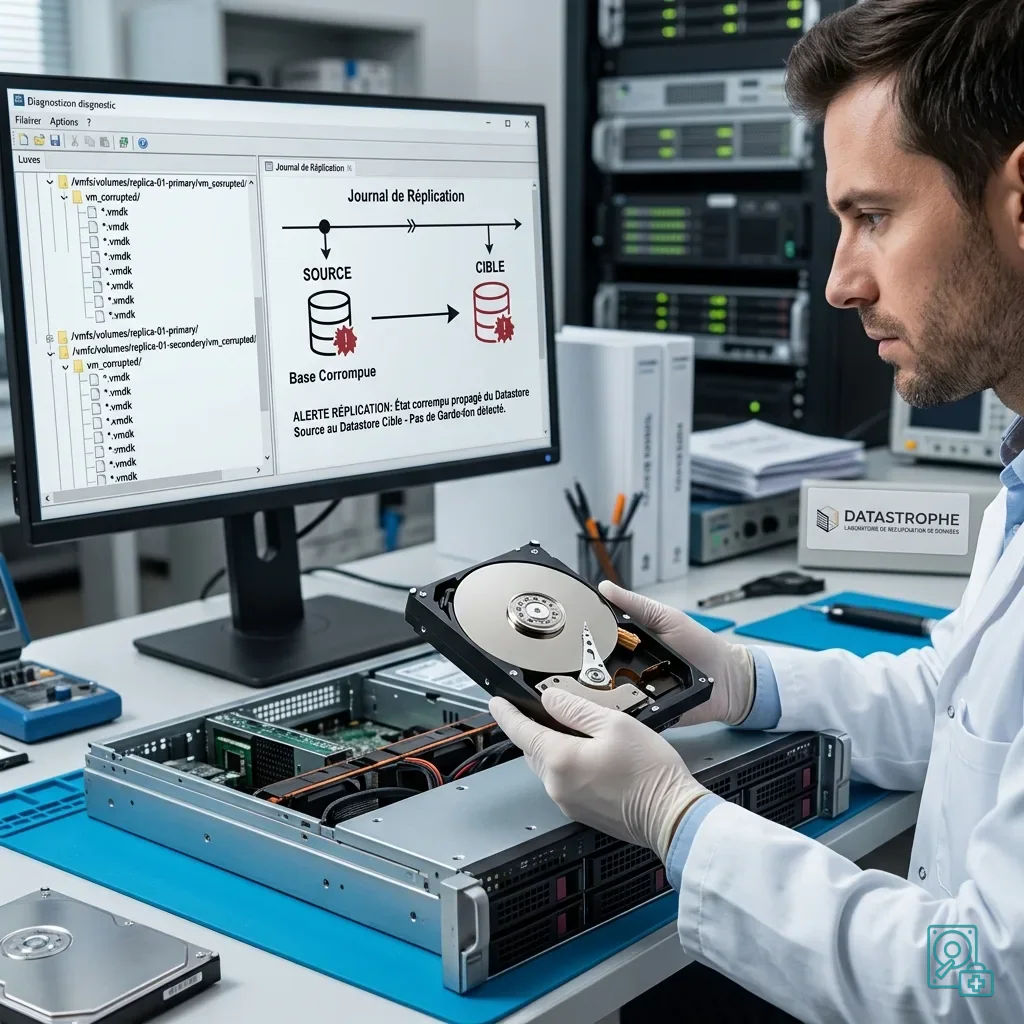
La réplication améliore la continuité face à une panne de site ou d'hôte, mais elle suit les changements. Une suppression, un chiffrement, une corruption de base ou un bloc virtuel incohérent peut atteindre la cible avant que l'incident soit détecté.
Disponibilité et récupération sont donc distinctes. Démarrer la cible rapidement peut remettre le service en ligne avec les mêmes données abîmées et générer de nouvelles écritures. Il faut conserver le point de réplication avant la reprise et vérifier les priorités.
Le télétravail ajoute caches, dossiers synchronisés, VPN et copies locales. Plusieurs versions concurrentes peuvent exister hors de l'interface centrale. Elles doivent être figées et datées avant que la synchronisation ne choisisse automatiquement un vainqueur.
L'article sur le disque virtuel en télétravail et les risques de synchronisation détaille cette situation. Les mécanismes sont suspendus le temps d'identifier quelle copie précède la perte et laquelle a déjà reçu l'erreur.
Une réplication utile doit être complétée par des versions et des restaurations testées. Le contrôle ouvre les fichiers, vérifie les bases et lance les applications prioritaires dans un environnement isolé. Le simple démarrage de la VM n'est pas une validation.
Diagnostic
Conserver davantage que le fichier principal
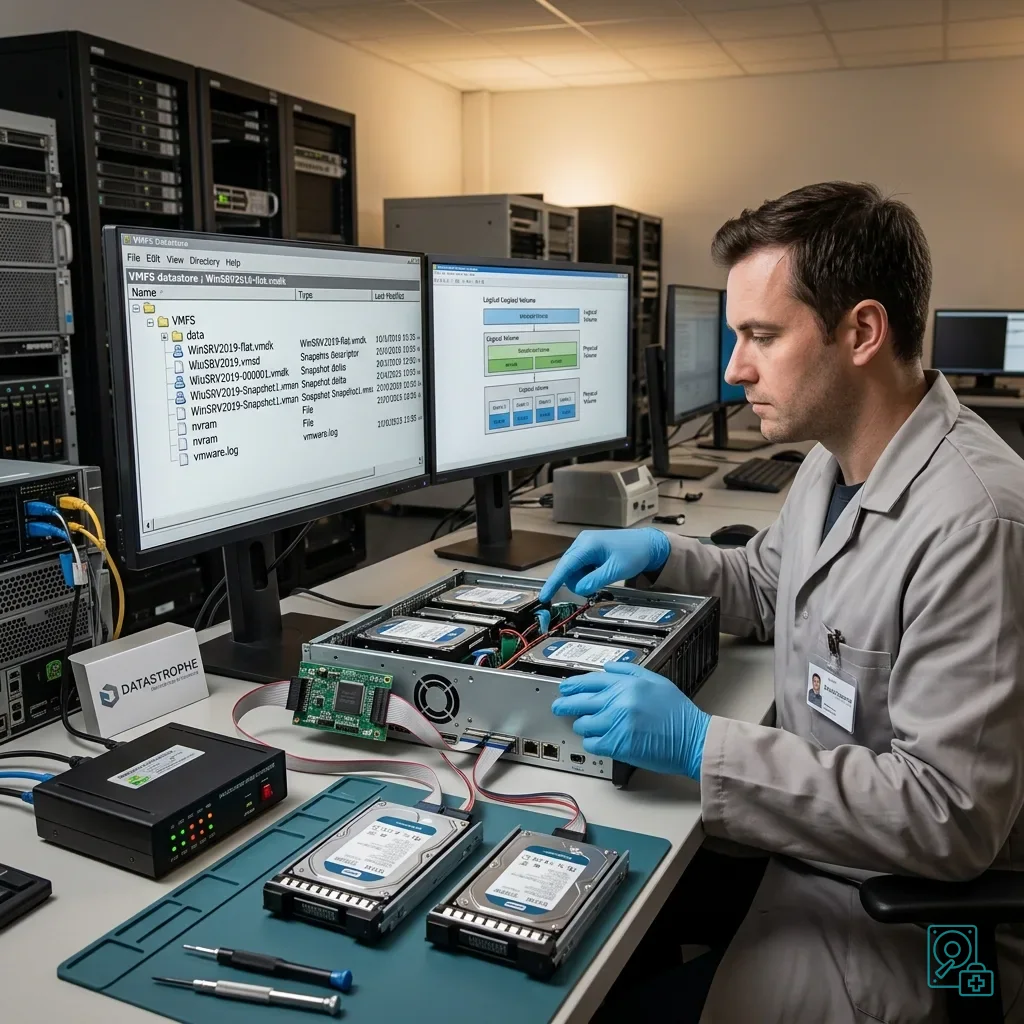
Un disque virtuel peut nécessiter le descripteur, la configuration, la chaîne de snapshots, les journaux, le contrôleur et les métadonnées de l'espace de stockage. Copier uniquement le fichier le plus volumineux laisse parfois de côté l'état courant ou les informations nécessaires à son attachement.
Préservez VMDK, VHDX et équivalents avec le dossier complet de la VM. Relevez UUID, ordre des disques, taille provisionnée, format, hyperviseur et chemin. Une empreinte des copies aide à distinguer la source de chaque variante testée.
Évitez les déplacements improvisés vers un autre stockage. Une copie partielle depuis un volume instable peut sembler complète par sa taille tout en contenant des zones manquantes. L'original reste figé et les transferts doivent être journalisés.
Pour les bases, messageries et services critiques, la validation est applicative. Un système démarré peut rejouer des journaux ou masquer des tables incohérentes. Les tests portent sur les enregistrements, périodes et fonctions dont l'organisation a besoin.
Cette approche rejoint le contrôle qualité en récupération de données. La restitution distingue les fichiers détectés, ouverts, réparés ou partiels, avec leur provenance ; une arborescence seule n'est pas une preuve d'exploitabilité.
Diagnostic
Préserver les états avant toute réparation
Suspendez consolidation, extension du volume, migration à chaud, réparation automatique et restauration au même endroit. Chacune de ces opérations écrit ou réorganise les fichiers. Elles peuvent rendre l'environnement plus propre tout en supprimant l'état recherché.
Inventoriez le format du disque, la configuration, les snapshots, les journaux, le stockage sous-jacent, les réplications et les sauvegardes. Ajoutez la chronologie des opérations et la liste des données critiques. Cette vue aide à choisir les sources à copier et l'ordre des analyses.
Si l'activité doit reprendre, utilisez une restauration ou une copie séparée. L'état incident reste hors ligne et non modifié. Le plan distingue clairement la continuité du service de la récupération des données manquantes.
Datastrophe analyse les couches pour différencier corruption logique, panne du stockage, chaîne rompue et mauvais état répliqué. Cette méthode ne garantit pas chaque fichier, mais évite de prendre une infrastructure sophistiquée pour une preuve de récupération.
Après l'incident, testez régulièrement les sauvegardes, limitez la durée des snapshots et conservez des versions indépendantes. Les procédures doivent préciser qui peut arrêter une VM, figer une réplication et autoriser une restauration.
La validation finale inclut les applications : base, messagerie, logiciel métier et fichiers prioritaires. Une protection devient crédible seulement lorsqu'un état sain peut être restauré à part, contrôlé puis replacé en production sans écraser les sources.
Diagnostic
Sources techniques primaires et limites
Périmètre documentaire — d'un disque virtuel: Pour récupération d'un disque virtuel, les références primaires retenues sont NIST SP 800-86. Preuve physique — d'un disque virtuel: Elles cadrent la préservation, la structure de stockage et la validation, sans prouver l’état physique exact, le comportement du contrôleur, la disponibilité des clés ni la cohérence métier du matériel reçu. Preuve contrôleur — d'un disque virtuel: Ces points exigent des mesures sur l’ensemble d’origine et des contrôles sur des copies.
Diagnostic
Faire établir un diagnostic contrôlé
Ensemble complet — d'un disque virtuel: Pour le diagnostic de récupération d'un disque virtuel, transmettez l’appareil ou le lot complet, les éléments d’alimentation et d’interface associés, l’ordre et les étiquettes, la chronologie des symptômes et la liste précise des données prioritaires. Chronologie d’incident — d'un disque virtuel: Les accès autorisés passent par un canal protégé distinct ; ne redémarrez pas la source uniquement pour obtenir une nouvelle capture.
Responsabilité du laboratoire — d'un disque virtuel: Datastrophe effectue directement le diagnostic, les contrôles d’intégrité et la récupération dans son propre laboratoire, avec sa propre équipe. Diagnostic gratuit — d'un disque virtuel: Le diagnostic et le devis sont gratuits. Limite du transport — d'un disque virtuel: Le transport privé aller-retour est compris ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Liste contrôlée — d'un disque virtuel: Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Classes de vérification — d'un disque virtuel: Chaque élément est classé, dans l’ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Déclenchement du paiement — d'un disque virtuel: Seuls les éléments recoverable_verified, ouverts et jugés exploitables, sont présentés comme récupérables. Résultat non vérifié — d'un disque virtuel: Le paiement intervient après acceptation de la liste et du prix.
Résultat non vérifié — d'un disque virtuel: Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. Pièce exceptionnelle — d'un disque virtuel: Une pièce rare, coûteuse et non remboursable constitue la seule exception et requiert une proposition séparée, explicite et chiffrée acceptée au préalable.