
Diagnostic
Chercher une cause commune aux alertes
Remplacer un disque isolé peut être une réponse normale. Lorsque plusieurs membres signalent des erreurs dans un intervalle court, il faut examiner ce qu'ils partagent : température, alimentation, backplane, contrôleur, vibrations, micrologiciel ou forte charge de reconstruction.
Un serveur concentre les unités dans une même baie et les sollicite en continu. Un flux d'air insuffisant ou une alimentation en limite affecte plusieurs supports, parfois à des moments différents. Les alertes rapprochées ne doivent donc pas être traitées comme des coïncidences indépendantes.
Rassemblez les erreurs SMART, les secteurs réalloués, les timeouts, les disques disparus, la latence d'entrée/sortie, la reconstruction figée et les événements des ventilateurs ou des alimentations. L'ordre permet de voir si un membre a réellement faibli avant les autres ou si plusieurs baies ont perdu le contact ensemble.
La récupération de données sur serveur prend en compte le volume et ses dépendances. L'objectif immédiat n'est pas de remettre chaque voyant au vert, mais de préserver la combinaison qui porte encore les données.
Chaque reconstruction relit intensivement les membres restants. Si l'un d'eux possède déjà des secteurs lents, cette charge peut le faire tomber avant la fin. Enchaîner les remplacements sans diagnostic consomme donc progressivement la redondance disponible.
Un redémarrage qui fait revenir un disque ne clôt pas l'incident. Une connexion intermittente, un backplane ou une tension instable peut réapparaître sous charge. Conservez l'événement et ne remettez pas automatiquement le volume en reconstruction.
Diagnostic
Contrôler les composants partagés
Le contrôleur RAID peut mal gérer les commandes, perdre son cache ou présenter un micrologiciel incohérent. Le backplane peut avoir un connecteur usé, oxydé ou mal inséré. Une alimentation instable peut provoquer plusieurs déconnexions que les journaux attribuent à tort aux disques.
Examinez si les erreurs suivent un numéro de baie ou le support lorsqu'il est déplacé, sans utiliser le volume critique pour multiplier les tests. La comparaison des journaux et d'un environnement connu aide à isoler la chaîne. Tout déplacement doit conserver l'ordre original.
La température doit être lue par emplacement et dans le temps. Poussière, ventilateur ralenti, obstruction ou baie dense peuvent créer un point chaud. Les disques les plus sollicités ou placés dans le flux le moins favorable signalent alors les premiers défauts.
L'article sur le serveur et les données critiques rappelle que le service hébergé doit guider l'urgence. Un diagnostic matériel utile protège d'abord la base, les VM ou les partages impossibles à restaurer ailleurs.
Exportez journaux du contrôleur, système, hyperviseur, supervision, alimentation et SMART avant leur rotation. Les heures, identifiants de baie et numéros de série doivent être rapprochés. Une simple liste actuelle ne montre pas le premier événement.
Cette chronologie distingue un disque réellement dégradé d'un membre déclaré absent après une panne de chaîne. Elle révèle aussi un ancien remplacement, un disque de secours ou une reconstruction déjà interrompue, éléments essentiels pour choisir la bonne topologie.
Diagnostic
Ne pas reconstruire tant que l'état reste incertain
La reconstruction est adaptée lorsque la source, la cible et l'infrastructure sont stables. Elle devient dangereuse avec plusieurs membres lents, des erreurs répétées ou une cause commune non corrigée. La parité reconstruite à partir d'une mauvaise combinaison peut figer des incohérences.
Évitez initialisation, import forcé, effacement du statut foreign, extension du volume et remplacements successifs. Ces commandes modifient les métadonnées et peuvent rendre impossible le retour à la configuration observée avant l'intervention.
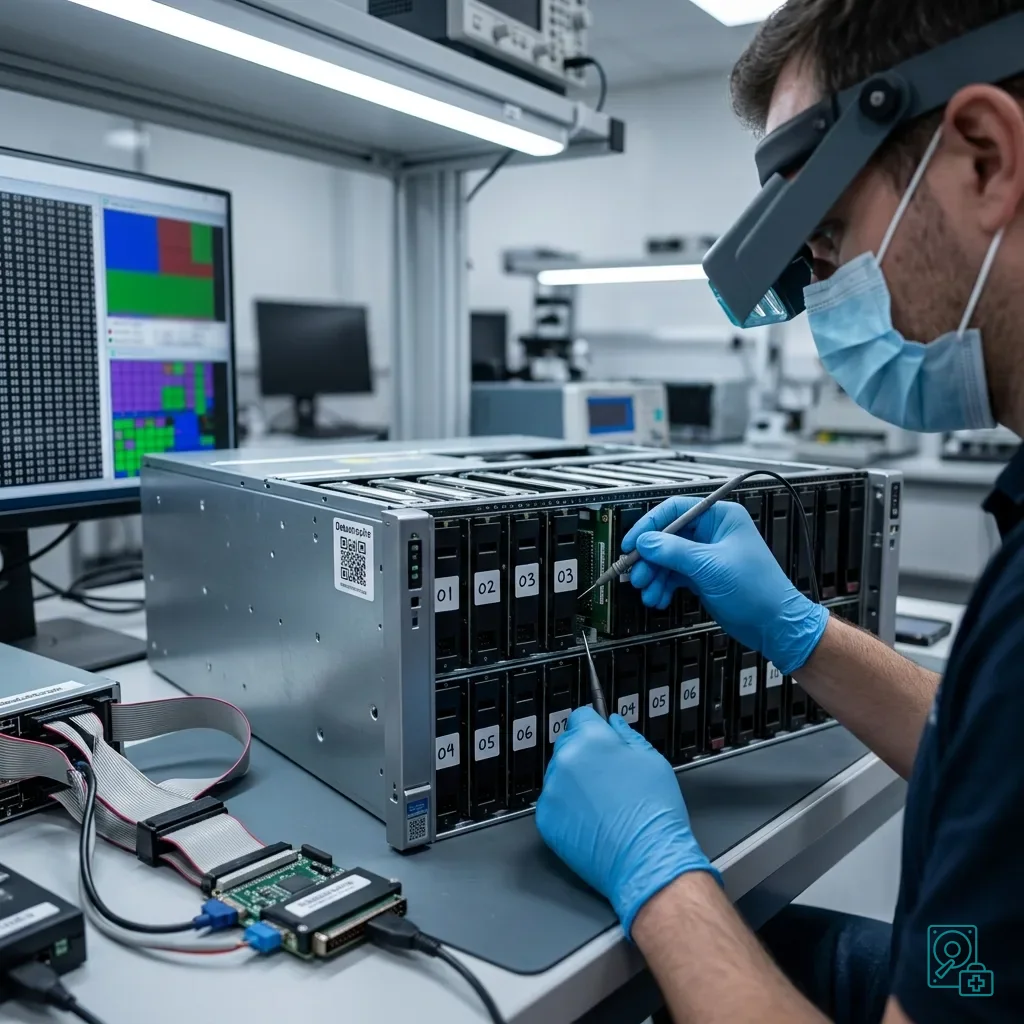
Photographiez l'ordre, relevez la configuration et acquérez les membres vers des supports sains lorsque les données le justifient. Les images permettent de tester la géométrie et la parité sans imposer une lecture répétée ni une écriture aux disques sources.
Les limites de la redondance RAID deviennent concrètes lorsque plusieurs unités faiblissent. Le RAID maintient certains services après une panne, mais il n'est ni une sauvegarde ni une garantie durant une reconstruction intensive.
Un volume qui remonte n'est pas automatiquement fiable. Partages, bases et machines virtuelles peuvent contenir des blocs incohérents ou manquer les dernières écritures. Une validation des données doit suivre toute reconstruction ou récupération.
Diagnostic
Organiser la récupération autour des services critiques
Classez les informations utiles : base métier, messagerie, partages, stockage de VM et fichiers de production selon leur impact et les sauvegardes disponibles. Cette hiérarchie détermine ce qu'il faut extraire tôt si la stabilité des membres ne permet pas une image complète.
La reprise peut utiliser une sauvegarde ou une copie isolée, sans écraser les sources. Gardez les disques, contrôleur et configuration tant que les données restaurées ne sont pas contrôlées. Le service redémarré et l'analyse de l'incident suivent deux chemins distincts.
Recensez les dépendances : journaux de base, descripteurs de VM, droits, fichiers de configuration et volumes annexes. Un composant principal isolé peut être visible mais ne pas permettre une reprise cohérente de l'application.
Le plan de récupération de données en entreprise facilite cette décision lorsque propriétaires et priorités sont connus. Le diagnostic technique gagne du temps si l'équipe sait quelles périodes et fonctions doivent être validées.
Communiquez des faits : niveau RAID, reconstruction arrêtée, baies concernées, membres instables, dernière sauvegarde et service prioritaire. Cette précision évite qu'une autre personne relance la tâche ou retire un disque sans connaître l'état collectif.
Diagnostic
Documenter la prévention
Après récupération, corrigez la cause commune. Remplacer des disques ne résout ni un backplane oxydé, ni une alimentation faible, ni une température excessive. Vérifiez câblage, flux d'air, micrologiciel, vibrations et charge prévue avant de reconstruire la production.
Testez les alertes et leur acheminement. Une notification SMART ou RAID sans responsable ni délai d'action laisse une panne simple évoluer jusqu'à la perte de redondance. Les journaux doivent être conservés assez longtemps pour relier plusieurs événements.
Restaurez régulièrement les sauvegardes sur une infrastructure séparée. Elles doivent couvrir tous les volumes et une période utile. Une copie sur le même serveur ou une tâche déclarée réussie sans contrôle applicatif ne constitue pas un plan de reprise fiable.
Tenez une fiche avec modèle, contrôleur, niveau RAID, ordre et rôle des membres, micrologiciel, emplacement, capacité et services hébergés. Ajoutez la procédure d'arrêt et les commandes interdites avant diagnostic. Cette fiche limite les essais improvisés.
Datastrophe peut analyser les membres et la reconstruction difficile pour préserver les données prioritaires, sans garantir tous les blocs. Le résultat distingue supports réellement faibles, cause commune probable et limites des images obtenues.
Dans un environnement virtualisé, incluez les espaces de stockage partagés, les fichiers de VM et les snapshots dans le contrôle. Un hôte qui redémarre peut encore héberger des disques virtuels incomplets. La validation doit descendre jusqu'aux applications et fichiers utilisés.
Diagnostic
Sources techniques primaires et limites
Périmètre documentaire — de disques serveur: Pour diagnostic de disques serveur, les références primaires retenues sont csrc.nist.gov. Preuve physique — de disques serveur: Elles cadrent la préservation, la structure de stockage et la validation, sans prouver l’état physique exact, le comportement du contrôleur, la disponibilité des clés ni la cohérence métier du matériel reçu. Preuve contrôleur — de disques serveur: Ces points exigent des mesures sur l’ensemble d’origine et des contrôles sur des copies.
Diagnostic
Faire établir un diagnostic contrôlé
Ensemble complet — de disques serveur: Pour le diagnostic de diagnostic de disques serveur, transmettez l’appareil ou le lot complet, les éléments d’alimentation et d’interface associés, l’ordre et les étiquettes, la chronologie des symptômes et la liste précise des données prioritaires. Chronologie d’incident — de disques serveur: Les accès autorisés passent par un canal protégé distinct ; ne redémarrez pas la source uniquement pour obtenir une nouvelle capture.
Responsabilité du laboratoire — de disques serveur: Datastrophe effectue directement le diagnostic, les contrôles d’intégrité et la récupération dans son propre laboratoire, avec sa propre équipe. Diagnostic gratuit — de disques serveur: Le diagnostic et le devis sont gratuits. Limite du transport — de disques serveur: Le transport privé aller-retour est compris ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Liste contrôlée — de disques serveur: Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Classes de vérification — de disques serveur: Chaque élément est classé, dans l’ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Déclenchement du paiement — de disques serveur: Seuls les éléments recoverable_verified, ouverts et jugés exploitables, sont présentés comme récupérables. Résultat non vérifié — de disques serveur: Le paiement intervient après acceptation de la liste et du prix.
Résultat non vérifié — de disques serveur: Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. Pièce exceptionnelle — de disques serveur: Une pièce rare, coûteuse et non remboursable constitue la seule exception et requiert une proposition séparée, explicite et chiffrée acceptée au préalable.