
Évaluation
Chercher une cause commune aux alertes
Remplacer un disque isolé peut être normal. Lorsque plusieurs membres signalent des erreurs en peu de temps, examinez ce qu'ils partagent : température, alimentation, fond de panier, contrôleur, vibrations, micrologiciel ou lourde charge de reconstruction.
Un serveur regroupe les unités dans une même baie et les sollicite sans arrêt. Un débit d'air insuffisant ou un bloc à sa limite peut toucher plusieurs disques à des moments différents. Des alertes rapprochées ne doivent pas être traitées comme des coïncidences.
Rassemblez les erreurs SMART, secteurs réalloués, délais, disparitions, latence d'entrée-sortie, reconstruction figée et événements des ventilateurs ou blocs. Leur ordre montre si un membre a faibli en premier ou si plusieurs baies ont perdu le contact ensemble.
La récupération de données sur serveur tient compte du volume et de ses dépendances. La priorité n'est pas de remettre tous les voyants au vert, mais de préserver la combinaison qui contient encore les données.
Chaque reconstruction lit intensivement les membres restants. Si l'un possède déjà des secteurs lents, la charge peut le faire tomber avant la fin. Remplacer les disques en série sans diagnostic consomme peu à peu la redondance disponible.
Un redémarrage qui fait réapparaître une unité ne clôt pas l'incident. Une connexion intermittente, un fond de panier ou une tension instable peut rechuter sous charge. Conservez l'événement sans relancer automatiquement la reconstruction.
Évaluation
Contrôler les composants partagés
Le contrôleur RAID peut mal gérer les commandes, perdre son cache ou employer un micrologiciel incohérent. Le fond de panier peut avoir une prise usée, oxydée ou mal insérée. Une alimentation instable produit aussi des déconnexions que les journaux attribuent parfois aux disques.
Examinez si les erreurs suivent la baie ou le support lorsqu'il est déplacé, sans multiplier les tests sur le volume critique. Les journaux et un environnement connu aident à isoler la chaîne. Tout déplacement doit préserver l'ordre original.
Lisez la température par emplacement et dans le temps. La poussière, un ventilateur ralenti, une obstruction ou une baie dense crée parfois un point chaud. Les unités les plus sollicitées ou les moins ventilées signalent alors les premiers défauts.
L'article sur le serveur et les données critiques rappelle que le service hébergé guide l'urgence. Un bon diagnostic matériel protège d'abord la base, les VM ou les partages impossibles à restaurer ailleurs.
Exportez les journaux du contrôleur, du système, de l'hyperviseur, de la supervision, du bloc et SMART avant leur rotation. Rapprochez les heures, les identifiants de baie et les numéros de série; une liste actuelle ne révèle pas le premier événement.
Cette chronologie distingue un disque réellement usé d'un membre déclaré absent après une panne de chaîne. Elle révèle également un ancien remplacement, un disque de relève ou une reconstruction interrompue, indispensables au choix de la topologie.
Évaluation
Ne pas reconstruire tant que l'état reste incertain
La reconstruction convient lorsque la source, la cible et l'infrastructure sont stables. Elle devient dangereuse avec plusieurs membres lents, des erreurs répétées ou une cause commune non corrigée. Une mauvaise combinaison peut figer des incohérences dans la parité.
Évitez l'initialisation, l'import forcé, l'effacement du statut foreign, l'extension du volume et les remplacements successifs. Ces commandes changent les métadonnées et peuvent empêcher le retour à la configuration observée.
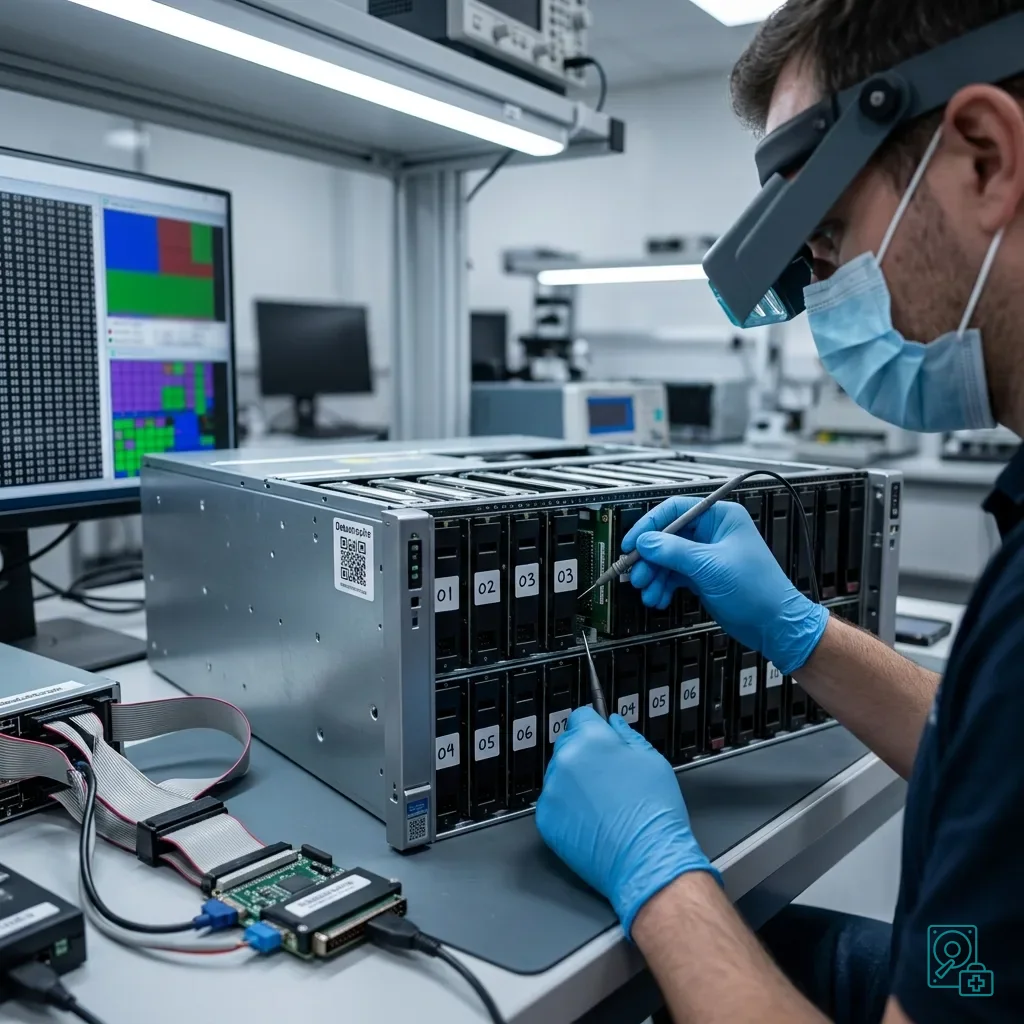
Photographiez l'ordre, relevez les paramètres et acquérez les membres vers des supports sains lorsque la valeur le justifie. Les images permettent de tester la géométrie et la parité sans répéter les lectures ni écrire sur les sources.
Les limites de la redondance RAID deviennent concrètes lorsque plusieurs unités faiblissent. Le RAID maintient certains services après une panne, mais ne constitue ni une sauvegarde ni une garantie sous une reconstruction intensive.
Un volume qui remonte n'est pas forcément fiable. Les partages, bases et machines virtuelles peuvent contenir des blocs incohérents ou manquer les dernières écritures; toute reconstruction doit être suivie d'une validation du contenu.
Évaluation
Organiser la récupération autour des services critiques
Classez les bases, les courriels, les partages, les VM et les fichiers de production selon leur impact et les sauvegardes disponibles. Cette hiérarchie détermine quoi extraire tôt lorsque les membres ne permettent pas une image complète.
La reprise peut utiliser une sauvegarde ou une copie isolée sans écraser les sources. Gardez les disques, le contrôleur et la configuration jusqu'à la vérification des données restaurées. Le redémarrage du service et l'analyse suivent deux parcours distincts.
Recensez les dépendances : journaux de base, descripteurs de VM, permissions, configurations et volumes annexes. Un composant principal isolé peut être visible sans permettre une reprise cohérente de l'application.
Le plan de récupération de données en entreprise facilite les décisions lorsque les propriétaires et priorités sont connus. Le diagnostic gagne du temps si l'équipe sait quelles périodes et fonctions valider.
Communiquez des faits : niveau RAID, reconstruction arrêtée, baies touchées, membres instables, dernière sauvegarde et service prioritaire. Cette précision empêche une autre personne de relancer la tâche ou de retirer un disque sans connaître l'état collectif.
Évaluation
Documenter la prévention
Après la récupération, corrigez la cause commune. De nouveaux disques ne résolvent ni un fond de panier oxydé, ni un bloc faible, ni une température excessive. Vérifiez le câblage, le débit d'air, le micrologiciel, les vibrations et la charge avant de reconstruire.
Testez les alertes et leur acheminement. Une notification SMART ou RAID sans responsable ni délai laisse une panne simple évoluer jusqu'à la perte de redondance. Conservez les journaux assez longtemps pour relier plusieurs événements.
Restaurez régulièrement les sauvegardes sur une infrastructure séparée. Elles doivent couvrir tous les volumes et une période utile. Une copie sur le même serveur ou une tâche réussie sans contrôle applicatif ne forme pas un plan fiable.
Tenez une fiche indiquant le modèle, le contrôleur, le niveau RAID, l'ordre et le rôle des membres, le micrologiciel, la capacité et les services. Ajoutez la procédure d'arrêt et les commandes interdites avant diagnostic.
Datastrophe peut analyser les membres et une reconstruction difficile afin de préserver les priorités, sans garantir tous les blocs. Le résultat distingue les supports faibles, la cause commune probable et les limites des images.
Dans un environnement virtualisé, incluez les espaces de stockage, les fichiers de VM et les instantanés. Un hôte qui redémarre peut encore contenir des disques virtuels incomplets; la validation doit atteindre les applications et les fichiers réellement utilisés.
Évaluation
Sources techniques primaires et limites
Périmètre documentaire — de disques serveur: Pour diagnostic de disques serveur, les sources primaires consultées sont csrc.nist.gov. Preuve physique — de disques serveur: Elles définissent les principes de préservation, de stockage et de validation, mais ne démontrent ni l’état physique précis, ni le comportement du contrôleur, ni la disponibilité des clés, ni la cohérence opérationnelle du matériel reçu. Preuve contrôleur — de disques serveur: Ces éléments doivent être mesurés sur l’ensemble original et vérifiés sur des copies.
Évaluation
Demander une évaluation contrôlée
Ensemble complet — de disques serveur: Pour évaluer diagnostic de disques serveur, fournissez l’appareil ou l’ensemble complet, les composantes d’alimentation et d’interface, l’ordre et les étiquettes des membres, l’historique des symptômes et la liste exacte des fichiers prioritaires. Chronologie d’incident — de disques serveur: Les accès autorisés sont transmis par un canal protégé distinct; évitez un nouveau démarrage uniquement pour produire une capture.
Responsabilité du laboratoire — de disques serveur: Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son propre laboratoire avec sa propre équipe. Diagnostic gratuit — de disques serveur: Le diagnostic et la soumission sont gratuits. Limite du transport — de disques serveur: Le transport privé aller-retour est inclus; le transporteur déplace seulement le colis scellé, sans accéder aux données ni les traiter.
Liste contrôlée — de disques serveur: Avant tout paiement, le client reçoit le prix proposé et une liste vérifiée. Classes de vérification — de disques serveur: Chaque élément est classé, dans l’ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Déclenchement du paiement — de disques serveur: Seuls les éléments recoverable_verified, ouverts et jugés utilisables, sont présentés comme récupérables. Résultat non vérifié — de disques serveur: Le paiement est demandé uniquement après l’acceptation de la liste et du prix.
Résultat non vérifié — de disques serveur: Si aucune donnée utilisable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucuns frais standards ne sont exigés. Pièce exceptionnelle — de disques serveur: La seule exception vise une pièce rare, coûteuse et non remboursable, commandée seulement après l’acceptation d’une proposition distincte, explicite et chiffrée.