
Évaluation
Comprendre le changement de régime sous reconstruction
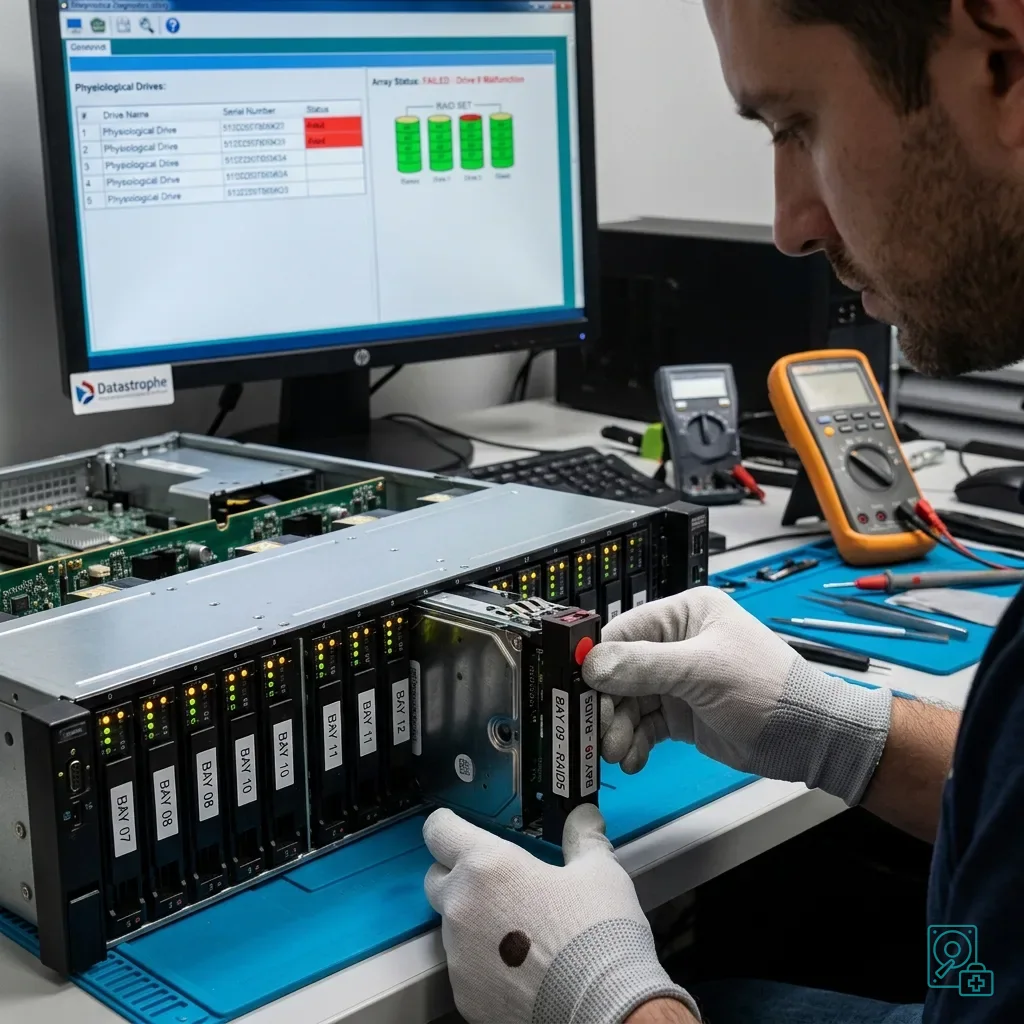
En fonctionnement normal, le RAID répartit une charge à l'occasion modérée. Dès qu'un membre tombe, la reconstruction ajoute des lectures sur tous les survivants, des calculs sur le contrôleur et des écritures sur le remplaçant, alors que les applications peuvent continuer à travailler.
Cette pression révèle des faiblesses latentes : des secteurs difficiles, une chaleur excessive, une alimentation à sa limite, un fond de panier intermittent ou un volume saturé. Le disque remplacé n'est donc pas toujours la seule cause du nouvel échec.
Surveillez la latence, les erreurs I/O, la progression qui stagne et les membres qui quittent l'ensemble. Un serveur encore en ligne peut être proche d'une perte plus large. Ces signaux imposent une décision, pas seulement de la patience.
La récupération de données sur système RAID traite le moment où maintenance et exploitation entrent en conflit. Elle préserve les membres avant que le contrôleur ne poursuive une reconstruction devenue risquée.
Figez l'état avant d'ajouter une opération : l’ordre, les journaux, le remplaçant, la progression et les messages. Ne restaurez pas sur le même volume et ne redémarrez pas sans trace pour tenter d'accélérer le processus.
Tenez compte du calendrier métier. Une clôture comptable, une copie de secours complète, un import massif ou une indexation changent fortement les I/O. La même reconstruction peut être tolérable au repos et critique durant ce pic.
Évaluation
Mesurer la charge ajoutée aux survivants
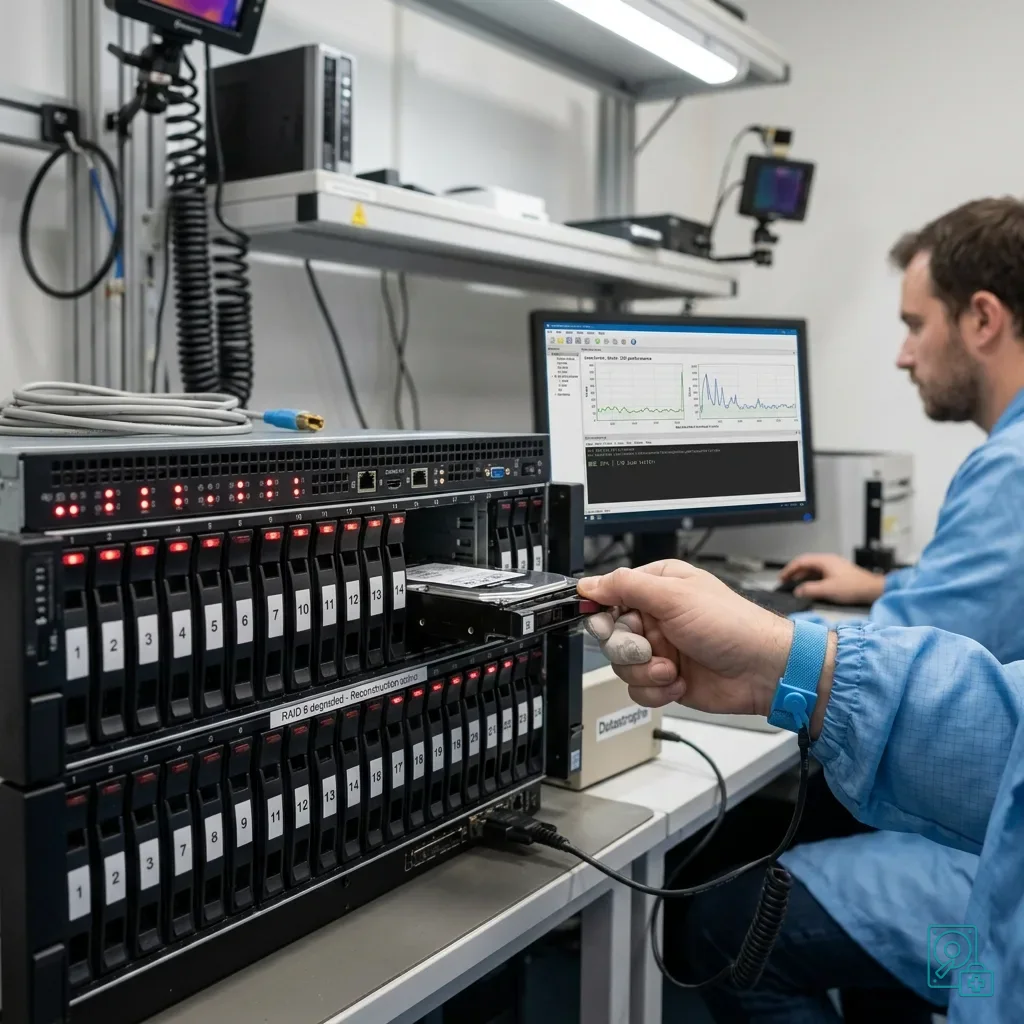
Une reconstruction lit les bandes, calcule le miroir ou la parité et écrit le nouveau membre. Ajoutez les VM, les bases, les scans et les copies de secours pour obtenir la charge réelle. Un pourcentage de reconstruction n'indique pas cette concurrence.
Un disque du même âge que le membre tombé a fréquemment subi la même chaleur et les mêmes vibrations. Les longues lectures peuvent rencontrer des secteurs jamais sollicités récemment. Une seconde erreur peut rendre certaines bandes impossibles à recomposer.
Examinez les journaux SMART, les journaux du contrôleur, du système et de l’hyperviseur avant de laisser l'opération continuer. Corrélez les erreurs avec les heures de charge. Une baisse de performance isolée ne suffit pas, mais une tendance croissante est un critère d'arrêt.
Le diagnostic des pannes répétitives de disques serveur aide à repérer un problème global. Plusieurs remplacements rapprochés ne doivent pas être traités comme une malchance indépendante.
Selon le niveau RAID, le nombre de membres faibles et la priorité, réduisez la charge, arrêtez proprement ou acquérez les sources avant reconstruction. La décision protège les données, même si elle retarde le retour de la redondance.
Évaluation
Chercher la cause commune hors des disques
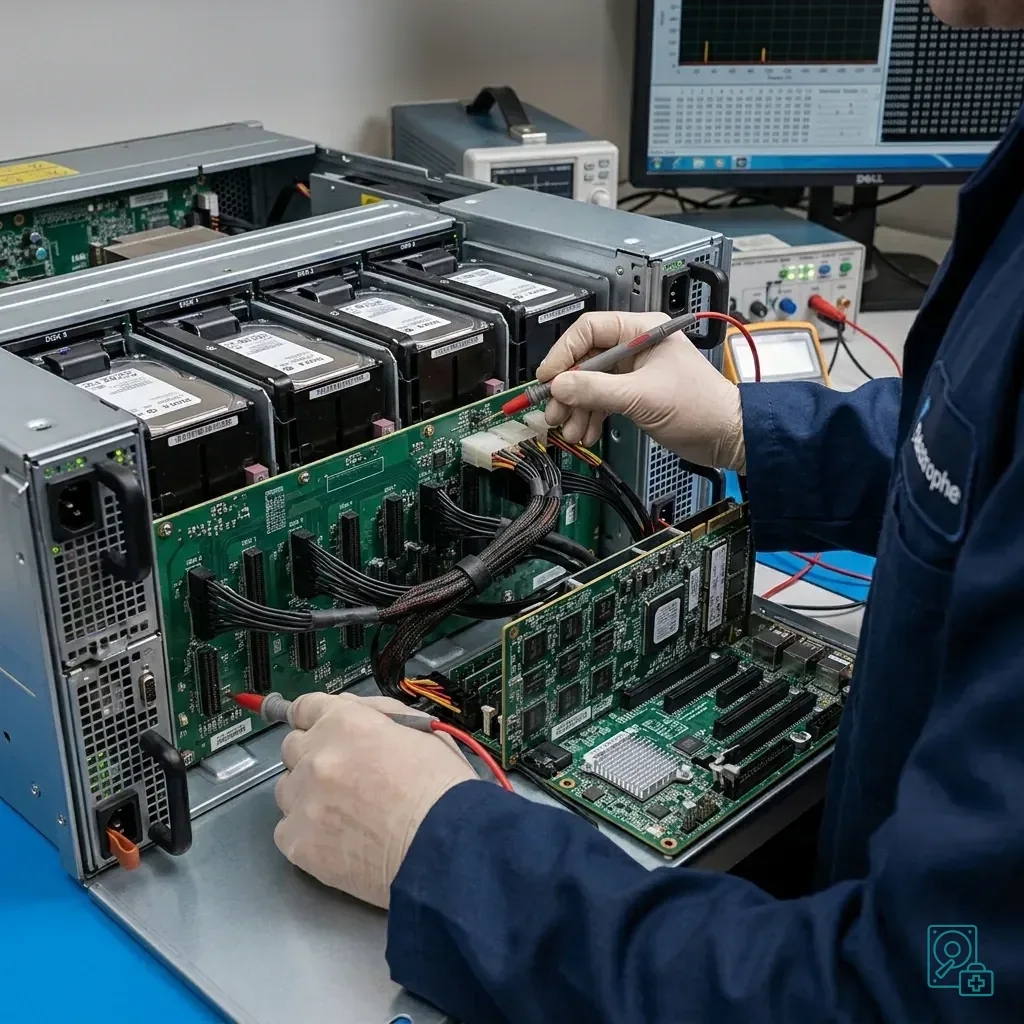
Le contrôleur, le fond de panier, les câbles, l’alimentation et la ventilation peuvent produire des erreurs sur plusieurs baies. Testez-les avec des supports sans données uniques. Remplacer un disque ne corrige pas un chemin intermittent.
Le fond de panier peut perdre le contact sous l’effet des vibrations ou de la chaleur et désigner successivement plusieurs membres. Gardez l'ordre et les journaux. Les sources ne doivent pas servir à tester différentes baies durant l'incident.
Une alimentation proche de sa limite ou une baie dense peut devenir instable précisément lorsque tous les disques travaillent. Mesurez les températures et les tensions sous une charge comparable, mais seulement après préservation des données.
Les limites de la redondance RAID incluent ces causes partagées. Aucun niveau ne protège d'un contrôleur qui écrit mal, d'une erreur humaine ou d'une copie de secours inexistante.
Le diagnostic relie donc le matériel commun, le niveau, l’ordre, les métadonnées et l’historique des remplacements. Une géométrie logique correcte ne suffit pas si le chemin physique continue à couper les supports.
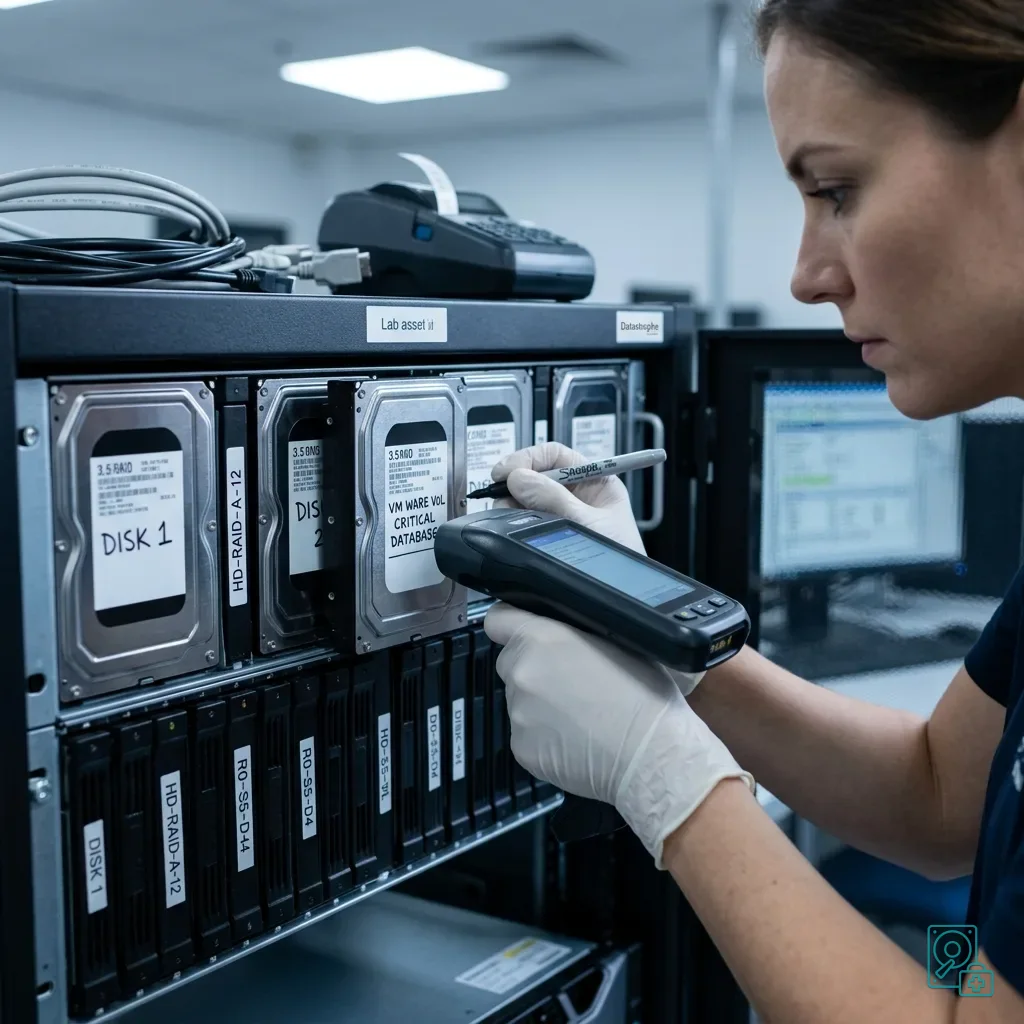
Évaluation
Prioriser les données avant le service
Classez les informations utiles : les bases, les VM, la messagerie, les dossiers clients, la production et les archives. Précisez la période, l’application et le responsable. La valeur métier doit guider la lecture d'un disque fragile plutôt que l'ordre des volumes.
Préparez une reprise séparée depuis une copie de secours vérifiée, sans restaurer sur les membres. Les sources restent disponibles pour le delta récent. Les synchronisations sont suspendues jusqu'à comparaison.
Notez le membre remplacé, la baie, l’heure, la progression, les redémarrages et les tâches déclenchées. Cette chronologie évite de répéter l'action qui a fait stagner la reconstruction ou de confondre ses effets avec la panne initiale.
Le dossier serveur et perte de données critiques replace la technique dans l'urgence métier. Une reprise ciblée peut être préférable à plusieurs jours de reconstruction sous charge.
Un volume revenu en ligne n'est pas encore sain. Ouvrez les fichiers prioritaires, contrôlez les bases et démarrez les VM sur une copie. Les erreurs applicatives peuvent subsister après un statut contrôleur vert.
Évaluation
Préparer une intervention maîtrisée
Rassemblez le modèle, le contrôleur, le niveau, l’ordre, les numéros de série, les remplaçants, les journaux, les alertes et la progression. Ajoutez la liste des données et des copies de secours testées. Ces faits évitent une méthode fondée sur le seul disque marqué absent.
Ne mélangez pas les membres et ne les testez pas un par un en écriture. Photographiez les baies et gardez les anciens disques et les disques de secours. Une importation forcée peut réécrire les rôles nécessaires à la reconstruction.
Si le serveur doit rester partiellement disponible, précisez exactement les services et la durée. Planifiez si possible un environnement de reprise séparé. Dans certains cas, l'arrêt contrôlé demeure le choix le moins risqué.
Datastrophe distingue la panne d’un membre, la cause commune, la géométrie et la corruption logique. L'objectif est une restitution validée sur un stockage sain, pas un redémarrage immédiat du matériel à tout prix.
Après l’incident, testez les copies de secours, les alertes, la ventilation et la procédure de reconstruction. Consignez la configuration hors du serveur. Ces contrôles empêchent une nouvelle panne isolée de devenir une crise complète.
Pour un environnement virtualisé, ajoutez les banques de données, les fichiers de VM, les snapshots et les applications à la validation. La fin de la reconstruction côté contrôleur ne garantit pas que les écritures invitées interrompues soient cohérentes.
Évaluation
Sources techniques primaires et limites
Périmètre documentaire — RAID sous charge sur un serveur: Pour risques d’une reconstruction RAID sous charge sur un serveur, les sources primaires consultées sont Linux MD administration guide. Preuve physique — RAID sous charge sur un serveur: Elles définissent les principes de préservation, de stockage et de validation, mais ne démontrent ni l’état physique précis, ni le comportement du contrôleur, ni la disponibilité des clés, ni la cohérence opérationnelle du matériel reçu. Preuve contrôleur — RAID sous charge sur un serveur: Ces éléments doivent être mesurés sur l’ensemble original et vérifiés sur des copies.
Évaluation
Demander une évaluation contrôlée
Ensemble complet — RAID sous charge sur un serveur: Pour évaluer risques d’une reconstruction RAID sous charge sur un serveur, fournissez l’appareil ou l’ensemble complet, les composantes d’alimentation et d’interface, l’ordre et les étiquettes des membres, l’historique des symptômes et la liste exacte des fichiers prioritaires. Chronologie d’incident — RAID sous charge sur un serveur: Les accès autorisés sont transmis par un canal protégé distinct; évitez un nouveau démarrage uniquement pour produire une capture.
Responsabilité du laboratoire — RAID sous charge sur un serveur: Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son propre laboratoire avec sa propre équipe. Diagnostic gratuit — RAID sous charge sur un serveur: Le diagnostic et la soumission sont gratuits. Limite du transport — RAID sous charge sur un serveur: Le transport privé aller-retour est inclus; le transporteur déplace seulement le colis scellé, sans accéder aux données ni les traiter.
Liste contrôlée — RAID sous charge sur un serveur: Avant tout paiement, le client reçoit le prix proposé et une liste vérifiée. Classes de vérification — RAID sous charge sur un serveur: Chaque élément est classé, dans l’ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Déclenchement du paiement — RAID sous charge sur un serveur: Seuls les éléments recoverable_verified, ouverts et jugés utilisables, sont présentés comme récupérables. Résultat non vérifié — RAID sous charge sur un serveur: Le paiement est demandé uniquement après l’acceptation de la liste et du prix.
Résultat non vérifié — RAID sous charge sur un serveur: Si aucune donnée utilisable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucuns frais standards ne sont exigés. Pièce exceptionnelle — RAID sous charge sur un serveur: La seule exception vise une pièce rare, coûteuse et non remboursable, commandée seulement après l’acceptation d’une proposition distincte, explicite et chiffrée.