
Évaluation
Un SSD de NAS n'a pas les contraintes d'un poste
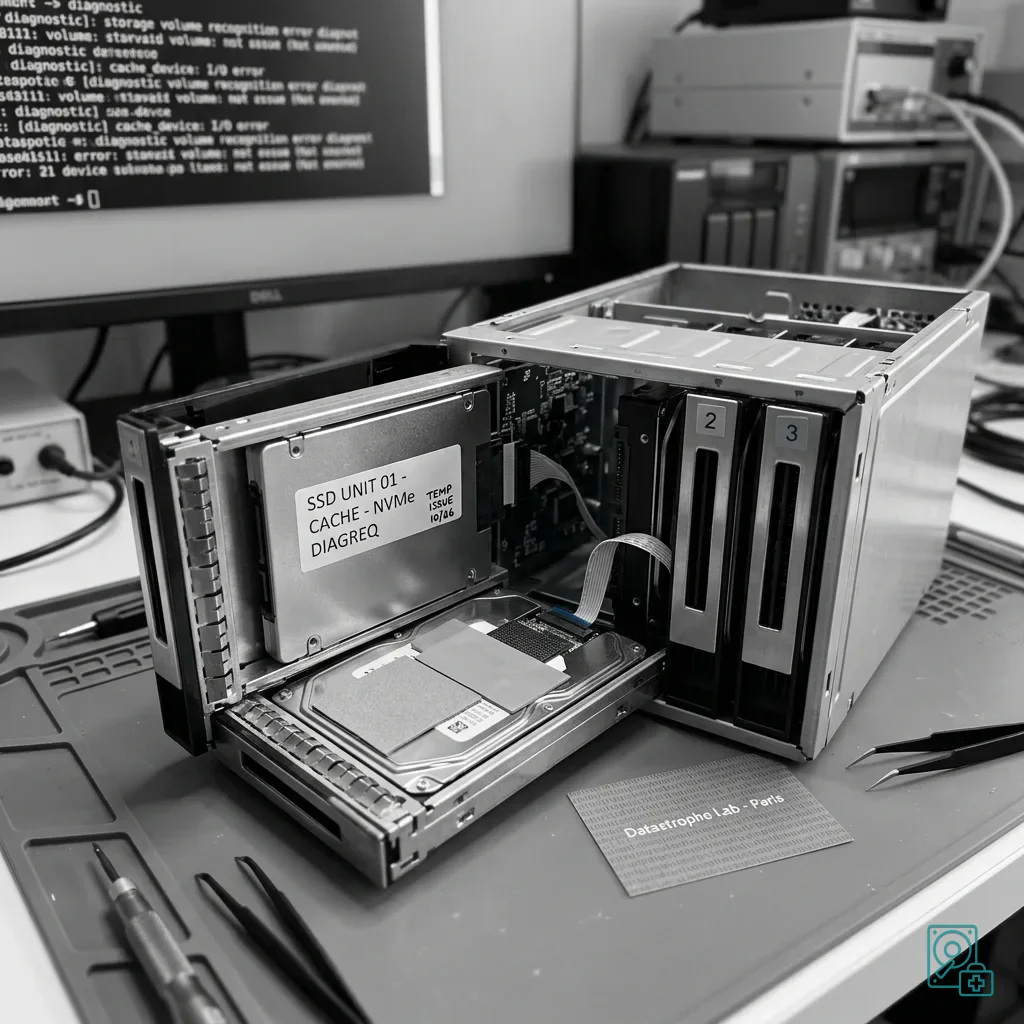
Dans un NAS, le SSD peut fonctionner jour et nuit dans une baie dense. Il sert à l'occasion de volume, de cache, de tiering, de support système ou d'espace pour VM. Ces rôles produisent des écritures et températures très différentes de celles d'un poste utilisateur.
Une alerte thermique n'explique pas tout. Ventilation réduite, micrologiciel, endurance insuffisante, cache saturé et reconstruction RAID peuvent provoquer le même ralentissement. La chronologie et la charge servent à relier la chaleur au premier défaut.
Le risque dépend de la fonction exacte. Un cache de lecture contient en principe des copies, tandis qu'un cache d'écriture peut porter des blocs non encore confirmés. Un SSD principal appartient directement au volume et ne se retire pas comme un accélérateur.
La récupération de données sur système RAID replace le SSD dans l'ensemble NAS. La flash impose en plus ses contraintes de contrôleur, de TRIM et de gestion d'usure, différentes d'un disque mécanique.
Ne remplacez pas le module et ne lancez pas une reconstruction avant d'avoir exporté la configuration. Le NAS peut supprimer le cache, rejouer des journaux ou recalculer un volume. Une action de maintenance peut alors devenir une écriture destructive.
Gardez les alertes, courbes de température, ordre des baies et tâches actives. Un SSD proche de l'alimentation ou privé de flux d'air peut chauffer sans alerte visible jusqu'à sa première déconnexion.
Évaluation
Le cache SSD ajoute une couche de cohérence
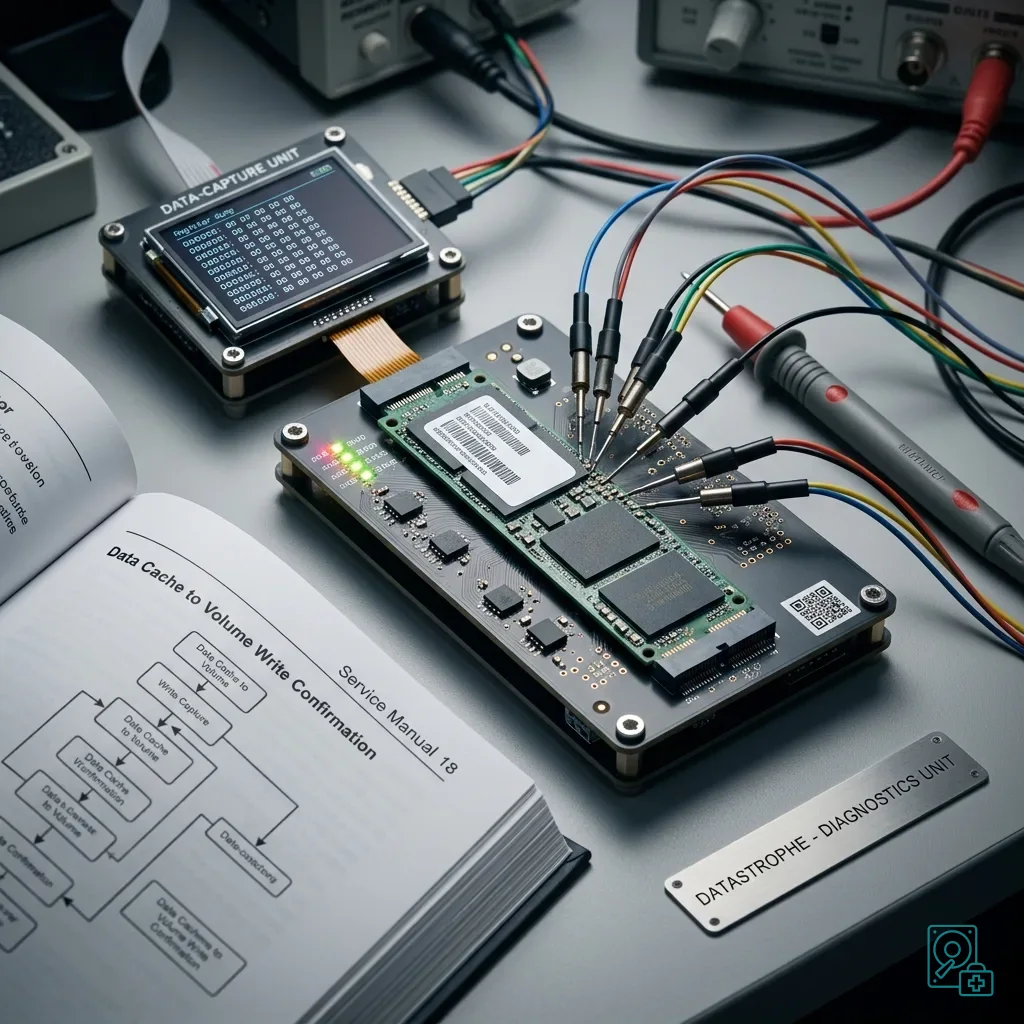
Repérez cache lecture, écriture, mode synchrone, miroir, tiering ou volume autonome. Relevez quels partages et services l'utilisent. Sans cette information, il est impossible de savoir si le SSD contient des copies ou un état plus récent que le RAID.
Gardez la configuration, les journaux, le SSD, les disques principaux et les disques de secours. Les identifiants et les compteurs indiquent si le cache avait été vidé, désactivé ou partiellement réintégré avant l'arrêt.
Ne validez pas « supprimer le cache » ou « réinitialiser » dans l'interface. L'opération peut invalider ses métadonnées et marquer les blocs comme disponibles. Les effets sont étudiés sur des copies de l'ensemble.
Le dossier sur les risques de récupération d'un NAS d'entreprise rappelle qu'un boîtier rassemble RAID, volumes, instantanés et services. Le cache SSD ajoute une chronologie supplémentaire à cette architecture.
La récupération doit comparer cache, volume principal, instantanés, VM et copies de secours. Se concentrer seulement sur le SSD chaud peut omettre les blocs déjà répercutés ou les dépendances nécessaires pour interpréter ceux qui restent.
Évaluation
Chaleur, endurance et charge se cumulent
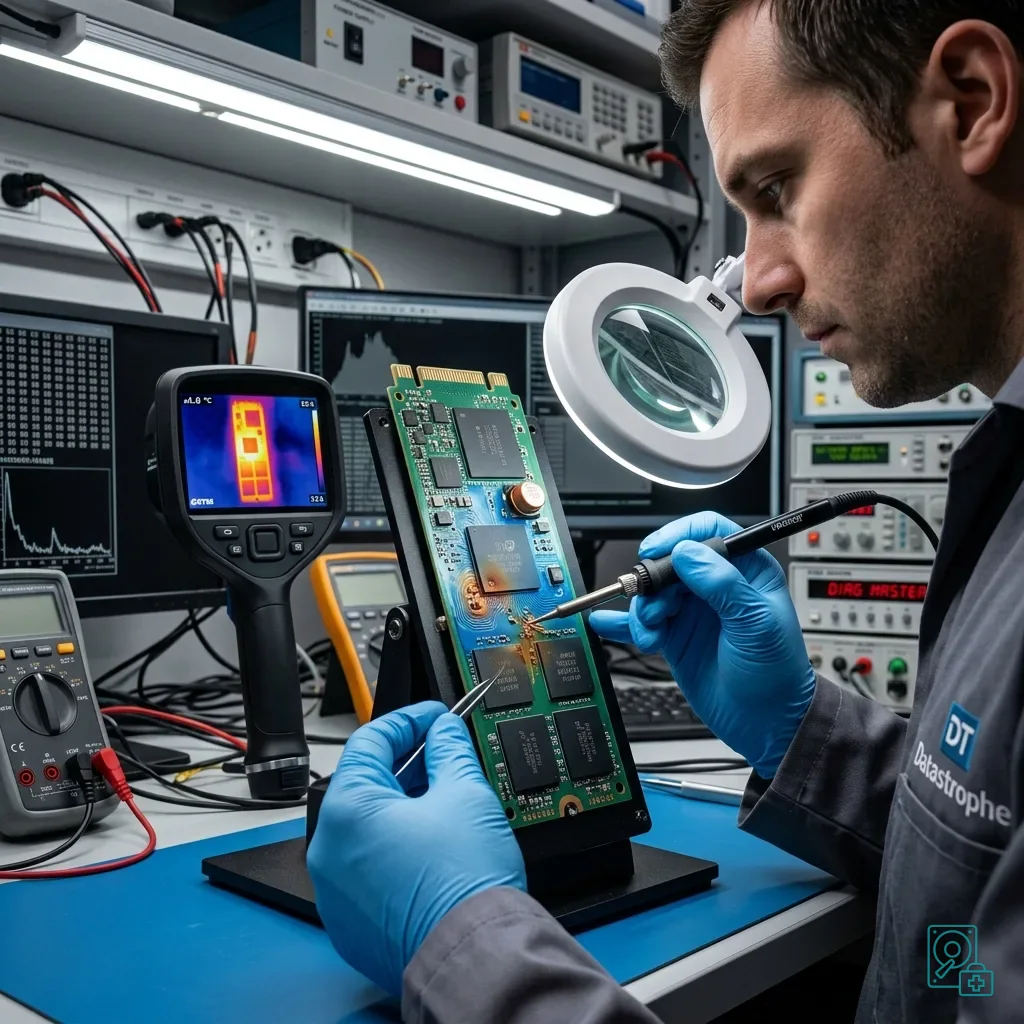
Le contrôleur et la NAND subissent écritures continues, nettoyage, déduplication ou journalisation. VM, vidéosurveillance et copies de secours de postes peuvent multiplier le volume écrit. L'endurance prévue doit être comparée à cette charge réelle.
Ralentissement, cache désactivé, erreur SMART, volume dégradé, SSD absent et instantanés bloqués sont lus ensemble. Une reconstruction lancée au même moment peut expliquer la hausse de température autant qu'une panne thermique initiale.
Une mauvaise ventilation touche plusieurs composants. Disques voisins, contrôleur, alimentation et SSD peuvent devenir instables dans la même baie. Remplacer seulement le module ne corrige pas une cause commune.
Les limites de récupération des SSD NVMe, du contrôleur et de TRIM s'appliquent aussi ici. Un support encore détecté peut nettoyer des blocs ou perdre sa traduction durant des tests prolongés.
Évitez scans, benchmarks et copie massive sur le NAS incident. Ces opérations ajoutent chaleur et charge. Une acquisition externe et priorisée protège mieux les dernières lectures utiles du SSD et des membres RAID.
Évaluation
Protéger tout le NAS avant de reconstruire
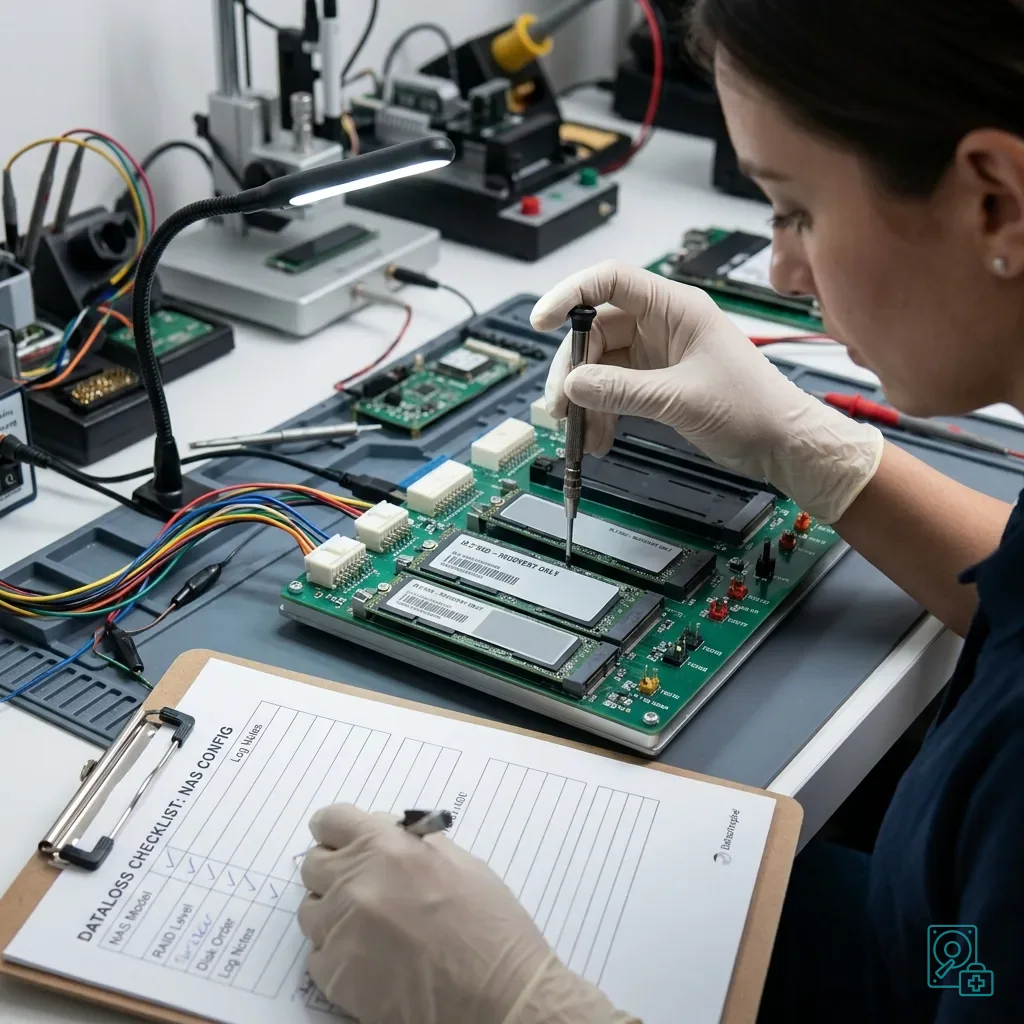
Inventoriez le modèle, micrologiciel, rôle du SSD, niveau RAID, séries, ordre, volumes, instantanés et actions. Photographiez les baies avant retrait. Une configuration exacte évite de recréer l'ensemble à partir d'hypothèses.
Figez les services et écriture des clients. Si une continuité urgente est nécessaire, restaurez sur un autre stockage. Le NAS incident reste disponible pour comparer cache et volume sans nouvelles transactions.
Contrôlez les copies de secours sur une destination indépendante. Leur date, exclusions et capacité d'ouverture déterminent le delta. Ne restaurez rien vers le NAS avant d'avoir acquis les éléments manquants.
Le guide sur les risques d'une reconstruction RAID sous charge explique pourquoi une reconstruction peut épuiser des supports fragiles. Avec un cache instable, il peut aussi figer la mauvaise génération.
Classez partages, bases, photos, vidéos, VM et copies de secours de postes par période et impact. Les contrôles varient : une VM qui démarre, une archive qui s'ouvre et une base cohérente ne se valident pas de la même façon.
Évaluation
Prévenir les récidives sur un NAS équipé de SSD
Retenez un SSD adapté à l'endurance, au protocole et à la température du NAS. Dimensionnez la marge et le refroidissement pour les pics de reconstruction, pas seulement la charge moyenne.
Consignez le mode du cache et la procédure d'arrêt. L'équipe doit savoir si retirer un SSD supprime une copie ou des écritures non confirmées. Une validation à deux personnes limite les clics irréversibles.
Séparez instantanés locaux et copies de secours. Un instantané dans le même NAS ne protège ni contre la panne du boîtier ni contre une mauvaise reconstruction. Testez une copie externe avec les droits et applications.
Datastrophe analyse SSD, cache, RAID et fichiers comme un ensemble. Le retour du volume en ligne n'est pas assimilé à une récupération tant que les données prioritaires et leurs versions ne sont pas contrôlées.
Surveillez température, usure, erreurs et taille du cache avec des seuils exploitables. Une alerte doit déclencher copie et diagnostic avant que le NAS ne désactive automatiquement le module sous charge.
Lorsque caméras, VM ou backups écrivent en continu, intégrez cette charge au choix du support et au plan de reprise. La fiabilité vient de la configuration, des copies et des décisions d'incident, pas du seul mot SSD.
Évaluation
Sources techniques primaires et limites
Périmètre documentaire — SSD de NAS après une surchauffe: Pour données en cache d’un SSD de NAS après une surchauffe, les sources primaires consultées sont europe.kioxia.com. Preuve physique — SSD de NAS après une surchauffe: Elles définissent les principes de préservation, de stockage et de validation, mais ne démontrent ni l’état physique précis, ni le comportement du contrôleur, ni la disponibilité des clés, ni la cohérence opérationnelle du matériel reçu. Preuve contrôleur — SSD de NAS après une surchauffe: Ces éléments doivent être mesurés sur l’ensemble original et vérifiés sur des copies.
Évaluation
Demander une évaluation contrôlée
Ensemble complet — SSD de NAS après une surchauffe: Pour évaluer données en cache d’un SSD de NAS après une surchauffe, fournissez l’appareil ou l’ensemble complet, les composantes d’alimentation et d’interface, l’ordre et les étiquettes des membres, l’historique des symptômes et la liste exacte des fichiers prioritaires. Chronologie d’incident — SSD de NAS après une surchauffe: Les accès autorisés sont transmis par un canal protégé distinct; évitez un nouveau démarrage uniquement pour produire une capture.
Responsabilité du laboratoire — SSD de NAS après une surchauffe: Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son propre laboratoire avec sa propre équipe. Diagnostic gratuit — SSD de NAS après une surchauffe: Le diagnostic et la soumission sont gratuits. Limite du transport — SSD de NAS après une surchauffe: Le transport privé aller-retour est inclus; le transporteur déplace seulement le colis scellé, sans accéder aux données ni les traiter.
Liste contrôlée — SSD de NAS après une surchauffe: Avant tout paiement, le client reçoit le prix proposé et une liste vérifiée. Classes de vérification — SSD de NAS après une surchauffe: Chaque élément est classé, dans l’ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Déclenchement du paiement — SSD de NAS après une surchauffe: Seuls les éléments recoverable_verified, ouverts et jugés utilisables, sont présentés comme récupérables. Résultat non vérifié — SSD de NAS après une surchauffe: Le paiement est demandé uniquement après l’acceptation de la liste et du prix.
Résultat non vérifié — SSD de NAS après une surchauffe: Si aucune donnée utilisable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucuns frais standards ne sont exigés. Pièce exceptionnelle — SSD de NAS après une surchauffe: La seule exception vise une pièce rare, coûteuse et non remboursable, commandée seulement après l’acceptation d’une proposition distincte, explicite et chiffrée.