
Analyse
Télétravail et disque virtuel ajoutent des couches
En télétravail, « disque virtuel » peut désigner trois architectures qui ne produisent pas les mêmes sources. Dans un accès distant par VPN ou VDI, l'application, le partage ou la machine virtuelle reste généralement dans l'infrastructure de l'entreprise. Une VM locale, au contraire, place son fichier VMDK, VHDX ou équivalent sur le poste du collaborateur. Enfin, un dossier synchronisé ou un cache hors ligne répartit des états entre le poste et un serveur ou un cloud.
Identifier chaque autorité d'écriture
Le symptôme visible est souvent banal : dossier absent, fichier revenu dans une version ancienne, VM locale qui ne démarre plus ou erreur après une coupure réseau. Le risque dépend pourtant de l'autorité d'écriture, c'est-à-dire de la couche qui acceptait réellement les modifications à l'instant de l'incident. Une interface affichée sur le poste n'implique pas que les blocs aient été écrits sur ce poste.
La première étape consiste donc à qualifier la topologie, puis à suivre les changements d'autorité dans le temps. Un collaborateur peut être passé d'une session centrale à une copie hors ligne, avoir exécuté une VM sur son portable ou avoir reconnecté un dossier synchronisé. Chaque bascule désigne une source originale différente à préserver.
| Topologie | Autorité d'écriture habituelle | Source à préserver en priorité | Limite du poste distant |
|---|---|---|---|
| Accès VPN à une application ou session VDI | Serveur, partage ou VM centrale | VM et espace de stockage partagé centraux, journaux applicatifs et de session | Le poste peut ne conserver qu'un affichage, sauf téléchargement, redirection ou export local |
| VM exécutée localement | Disque virtuel et hyperviseur du poste | Fichier VMDK/VHDX, configuration, snapshots locaux et support hôte | Une copie centrale peut être absente ou antérieure |
| Dossiers ou caches synchronisés | Autorité alternante ou bidirectionnelle selon le client | État serveur ou cloud, chaque poste hors ligne, base du client et fichiers de conflit | L'icône de synchronisation ne prouve ni complétude ni cohérence |
Récupération de disque virtuel décrit le service dédié aux environnements virtualisés. Ici, l'angle est plus précis : retrouver l'ordre des versions créées par l'usage hors ligne, la reconnexion et les mécanismes de synchronisation autour du disque.
Un bon réflexe consiste à ne pas chercher immédiatement la dernière version affichée. La version la plus récente n'est pas forcément la plus saine. Une copie locale plus ancienne peut parfois contenir la structure exploitable, alors qu'une version synchronisée plus tard a déjà propagé l'incident.
Analyse
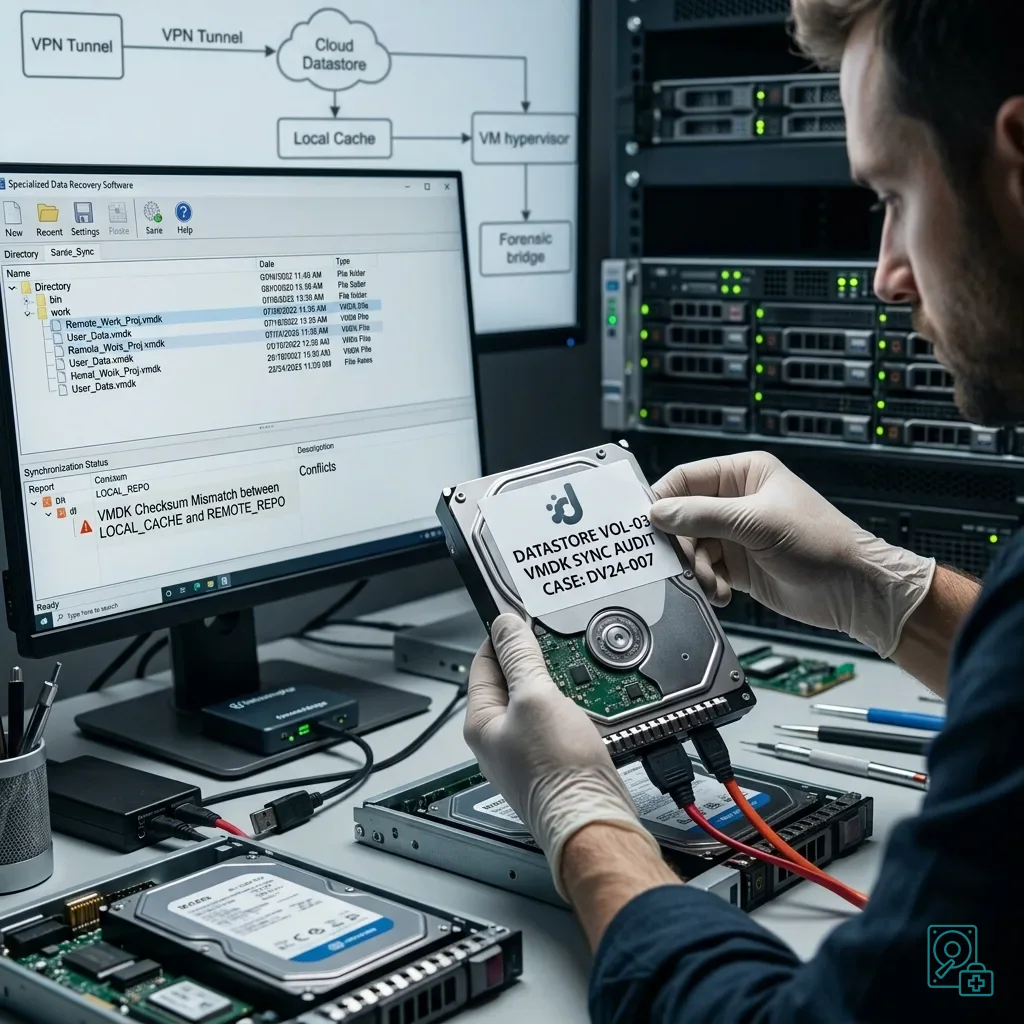
Synchronisation et VPN peuvent masquer la panne
Un VPN est un transport, pas un mécanisme de copie. S'il donne accès à une application ou à un partage central, l'écriture reste en principe côté serveur. Dans une session VDI, le disque virtuel appartient aussi à l'infrastructure centrale ; le poste ne devient une source de données que si des dossiers, périphériques, presse-papiers ou téléchargements ont été redirigés. Cette distinction évite de chercher un VMDK sur un ordinateur qui n'en a jamais hébergé.
Une VM locale inverse la priorité : son disque virtuel, sa configuration et sa chaîne de snapshots se trouvent sur le poste. La reconnexion au VPN peut rétablir des accès réseau sans déplacer cette source. Il faut préserver le support hôte et le dossier complet de la VM avant démarrage, consolidation ou copie partielle.
Les dossiers et caches synchronisés forment une troisième topologie. Le client peut renommer des fichiers en conflit, conserver une version temporaire, différer certains blocs ou propager une suppression. Après incident, il faut donc identifier ses règles et éviter de considérer l'icône de synchronisation comme une preuve d'intégrité.
La chronologie devient essentielle. Elle doit relever :
- Le début et la fin de la période hors ligne ;
- La topologie utilisée et toute bascule entre VDI, VM locale et dossier synchronisé ;
- La reconnexion au VPN et, séparément, le redémarrage du client de synchronisation ;
- L'utilisateur, l'application et les fichiers ouverts ;
- Les messages de conflit, renommages et sauvegardes déclenchées.
Ces informations aident à choisir la source à analyser en premier sans confondre horodatage récent et version cohérente.
Sur une VM locale, synchroniser le dossier actif qui contient un VMDK, un VHDX ou un fichier équivalent peut produire une version distante incomplète si le disque change pendant le transfert. La présence d'un fichier volumineux côté cloud ne prouve donc pas sa cohérence ni son statut de source originale.
Disque virtuel en cluster : signes de panne complète cette lecture côté infrastructure. En télétravail, le risque principal est moins le cluster lui-même que la dispersion des états entre poste, réseau et stockage.
Analyse
Snapshots et copies locales doivent être préservés
Un snapshot peut être utile, mais son emplacement dépend de la topologie. Pour une VDI, il appartient généralement à l'hyperviseur central ; pour une VM locale, il se trouve avec le dossier de la machine sur le poste. En cas de doute, il faut conserver le disque virtuel, ses descripteurs, sa configuration, toute la chaîne de snapshots et les journaux de l'hyperviseur concerné. Supprimer un élément pour gagner de la place peut rendre une reconstruction plus difficile.
Les copies locales méritent la même prudence sans être toutes assimilées à un disque virtuel. Un poste peut contenir un cache structuré par le client, une archive exportée, un dossier redirigé, une base temporaire ou le fichier complet d'une VM locale. Leur nature et leur dernière autorité d'écriture doivent être documentées avant de décider laquelle comparer ou acquérir.
Ne pas résoudre le conflit en ligne : reconnecter tous les postes ou choisir « conserver la version la plus récente » peut propager une suppression ou remplacer une copie encore exploitable. Les états sont d'abord isolés et inventoriés.
Il faut éviter de renommer ou de déplacer ces éléments sans trace. Si une copie est nécessaire, elle doit être faite vers un support sain, avec une note sur la source, l'heure, le poste et l'utilisateur. Le but n'est pas de tout figer administrativement, mais de garder une lecture exploitable de l'incident.
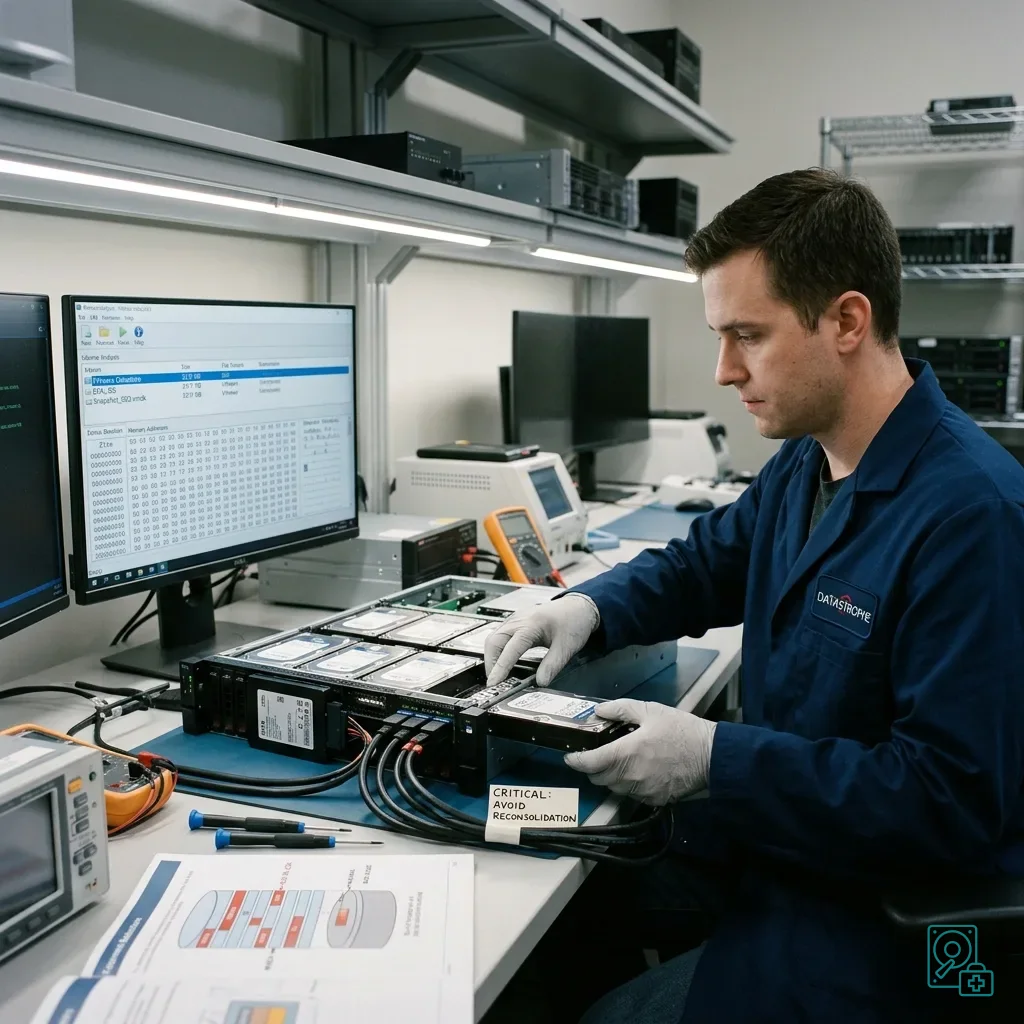
La tentation de consolider rapidement les snapshots est forte quand l'environnement manque d'espace. Pourtant, une consolidation modifie les fichiers et peut masquer le point de rupture. Si l'activité doit reprendre, il vaut mieux travailler sur un environnement séparé ou sur une copie clairement identifiée.
Cette méthode rejoint la logique de documentation d'incident. Plus l'environnement est distribué, plus la chronologie et la liste des sources deviennent importantes pour éviter une mauvaise restauration.
Analyse
Éviter les reconstructions précipitées
Après une panne, l'équipe informatique cherche souvent à remettre le service en route. C'est légitime, mais certaines actions peuvent réduire les chances de récupération : relancer une synchronisation globale, restaurer une sauvegarde au même emplacement, supprimer des fichiers en conflit, consolider des snapshots ou étendre un volume sans copie préalable.
La bonne question n'est pas seulement « comment redémarrer ». Elle est aussi « quelle couche écrivait, et quelle source devons-nous préserver avant de redémarrer ». Selon la topologie, l'état pertinent se trouve dans la VM ou le partage central, dans le dossier complet d'une VM locale, ou dans les états serveur et clients d'une synchronisation.
Il faut séparer reprise d'activité et récupération. Une reprise peut utiliser une copie de travail ou une restauration partielle, à condition de ne pas écraser les sources. La récupération, elle, doit analyser ce qui a été perdu, corrompu ou désynchronisé.
Les bases de données locales, fichiers métiers et archives compressées sont particulièrement sensibles. Une synchronisation partielle peut laisser un fichier visible mais inexploitable. Les fichiers de petite taille ne sont pas toujours prioritaires ; les fichiers structurants, eux, peuvent conditionner toute l'activité.
Avant toute opération corrective lourde, il faut lister les supports et comptes impliqués. Cette étape évite de chercher uniquement sur le serveur alors qu'une version saine existe encore sur un poste qui n'a pas terminé sa synchronisation.
Analyse
Préparer une reprise contrôlée
La prévention utile ne consiste pas à multiplier les copies sans méthode. Elle consiste à documenter la topologie, l'autorité d'écriture attendue, l'emplacement de la source originale, les éventuelles redirections VDI, les règles de synchronisation, la durée des versions et la personne autorisée à geler les échanges.
Pour les disques virtuels, il faut documenter le format, l'emplacement, les snapshots, les dépendances applicatives et les sauvegardes. Une architecture simple à expliquer sera plus simple à diagnostiquer le jour où un volume devient inaccessible.
Les utilisateurs en télétravail doivent aussi savoir quoi faire. Ne pas relancer dix fois l'application, ne pas supprimer les fichiers en conflit, ne pas vider un cache, ne pas restaurer localement sans consigne. Ces consignes sobres évitent souvent de transformer une perte limitée en incident plus large.
Une vérification régulière des sauvegardes est nécessaire, mais elle ne remplace pas la compréhension des synchronisations. Une sauvegarde peut avoir capturé un état déjà corrompu ou incomplet. Le contrôle doit donc porter sur la capacité réelle à ouvrir les fichiers critiques.
Quand la panne est déjà présente, Datastrophe peut analyser en laboratoire des copies de travail du disque virtuel, des snapshots, des caches et des copies locales. Si un poste ou un serveur porte aussi un support physique défaillant, son acquisition relève d'un diagnostic distinct ; la salle blanche ne concerne que certains disques magnétiques nécessitant une ouverture. L'objectif reste pragmatique : préserver les états, identifier la version la plus cohérente et restituer les données utiles sans promettre plus que les contrôles ne démontrent.
Sources techniques primaires et limites
Le NIST SP 800-86 recommande une collecte traçable et un examen sur des copies. Ce cadre ne qualifie ni les têtes, les surfaces, les alimentations, le pont d’interface ou les zones non lues du disque reçu, et ne permet pas de confondre détection et récupération vérifiée.
Faire qualifier le dossier « Disque virtuel en télétravail : synchronisation »
Transmettez à Datastrophe le disque et son boîtier éventuel, les alimentations et câbles, la chronologie de l’incident et des essais, les journaux de copie et la liste des données prioritaires. Les codes, clés et éléments d’authentification autorisés sont communiqués par un canal distinct ; ils ne sont jamais inscrits sur le support ni dans le colis.
Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son laboratoire, avec sa propre équipe. Le diagnostic et le devis sont gratuits. Le transport privé aller et retour est systématiquement pris en charge ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Chaque élément y est classé, dans cet ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Seuls les éléments recoverable_verified, dont le contenu a été contrôlé et jugé exploitable, sont présentés comme récupérables. Le client paie seulement après avoir accepté la liste et le prix ; la préparation du résultat et la restitution interviennent ensuite.
Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. La seule exception concerne une pièce rare, coûteuse et non remboursable : elle ne peut être commandée qu’après une proposition séparée, explicite et chiffrée.