
Analyse
Des pannes répétitives peuvent révéler une cause commune
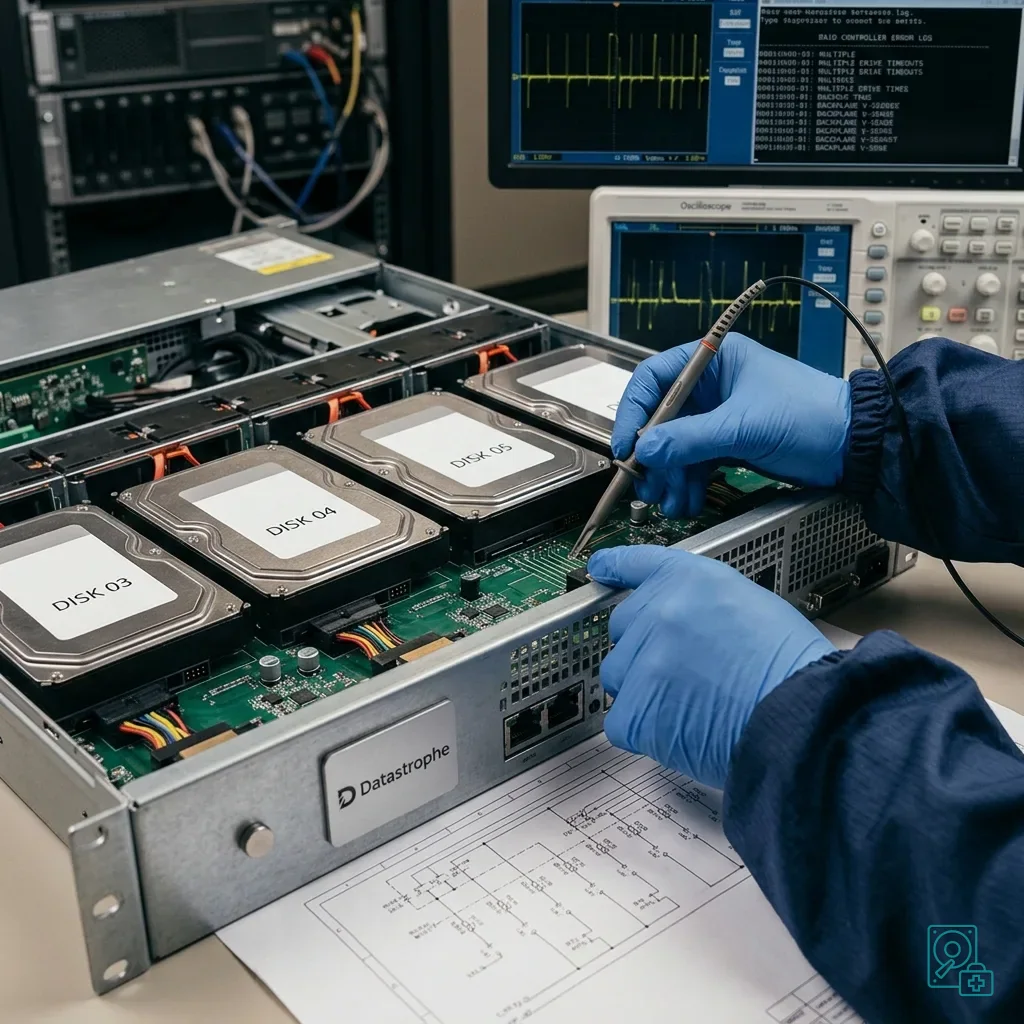
Quand un disque serveur signale une erreur, le réflexe habituel consiste à le remplacer. Quand plusieurs alertes apparaissent dans une période courte, il faut élargir le diagnostic. Le problème peut venir d'une cause commune : chaleur, alimentation, backplane, contrôleur RAID, vibrations, micrologiciel ou reconstruction trop sollicitante.
Corréler la baie et la chronologie
Un serveur concentre plusieurs dépendances. Les disques travaillent souvent en continu, dans une baie partagée, avec des contraintes de température et de charge. Une panne répétitive n'est donc pas toujours une série de hasards indépendants.
Les signes doivent être lus ensemble. SMART renseigne certains compteurs du disque, sans établir à lui seul la cause. Une disparition de membre peut aussi venir de la liaison, de la baie ou du contrôleur. L'accumulation d'alertes demande donc une chronologie plutôt qu'un verdict à partir d'un seul écran.
| Corrélation observée | Hypothèse à vérifier | Preuve complémentaire |
|---|---|---|
| Erreurs sur la même baie avec des disques différents | Connecteur ou backplane | Journaux de lien et test contrôlé de la baie |
| Resets simultanés sur plusieurs membres | Alimentation ou contrôleur | Événements horodatés et mesures électriques |
| Erreurs propres à un seul disque sur plusieurs interfaces | Support individuel | Télémétrie, lecture contrôlée et image |
| Dégradation pendant une reconstruction | Charge révélant des membres fragiles | Carte de lecture et ordre exact des événements |
Récupération de données sur serveur présente l'approche service. Le diagnostic se concentre sur la mécanique des pannes répétitives, souvent mal interprétées dans l'urgence.
Le risque principal est de remplacer un disque après l'autre sans comprendre pourquoi les erreurs se multiplient. Chaque reconstruction sollicite les supports restants. Si l'un d'eux est déjà fragile, cette charge peut déclencher une panne plus grave.
Il faut aussi se méfier des alertes qui disparaissent après redémarrage. Un disque revenu en ligne ne prouve pas que l'incident soit clos. Une connexion instable, une baie capricieuse ou une alimentation limite peut produire des erreurs intermittentes, souvent plus difficiles à diagnostiquer qu'une panne franche.
Analyse
RAID, backplane et alimentation doivent être vérifiés
Le RAID peut masquer une panne, mais il ne corrige pas toutes les causes. Un contrôleur instable, un backplane défectueux ou une alimentation irrégulière peut produire des erreurs sur plusieurs disques. Remplacer uniquement les supports ne règle pas le problème si la couche commune reste défaillante.
Le backplane mérite une attention particulière. Des connecteurs usés, de l'oxydation, une mauvaise insertion ou un défaut de baie peuvent faire disparaître un disque de manière intermittente. Le journal RAID peut alors ressembler à une panne disque, alors que le support n'est pas seul en cause.
Une corrélation n'est pas une preuve de cause : déplacer un disque, remplacer un câble ou changer de baie ne se fait que dans un protocole documenté. Plusieurs changements simultanés rendraient le résultat impossible à attribuer.
La chaleur est un autre facteur. Un serveur en baie mal ventilée, saturé de poussière ou exposé à une température élevée peut accumuler les erreurs. La panne peut apparaître sur les disques les plus sollicités ou les moins bien refroidis.
Serveur et données critiques rappelle l'importance de prioriser les services. Ici, le diagnostic matériel vise à éviter que la reprise détruise les dernières sources exploitables.
Les journaux doivent être conservés avant rotation. Contrôleur RAID, système, hyperviseur, supervision et alertes SMART racontent souvent la chronologie réelle : quel disque a signalé en premier, quelle reconstruction a démarré, quelle baie a perdu le contact.
Cette chronologie permet de distinguer le disque réellement défaillant du disque simplement déconnecté au mauvais moment. Elle évite aussi de retirer un support encore indispensable à la cohérence du volume.
Analyse
Éviter de reconstruire en boucle
La reconstruction RAID est utile quand le contexte est sain. Elle devient risquée si plusieurs disques sont instables, si les erreurs se répètent ou si la cause commune n'a pas été identifiée. Reconstruire en boucle peut consommer les dernières lectures possibles.
Il faut éviter les actions automatiques non documentées : remplacement successif, initialisation d'un volume, import forcé, suppression d'un disque marqué foreign, extension de volume ou restauration au même emplacement. Ces gestes peuvent modifier les métadonnées nécessaires au diagnostic.
Avant toute reconstruction, il faut préserver :
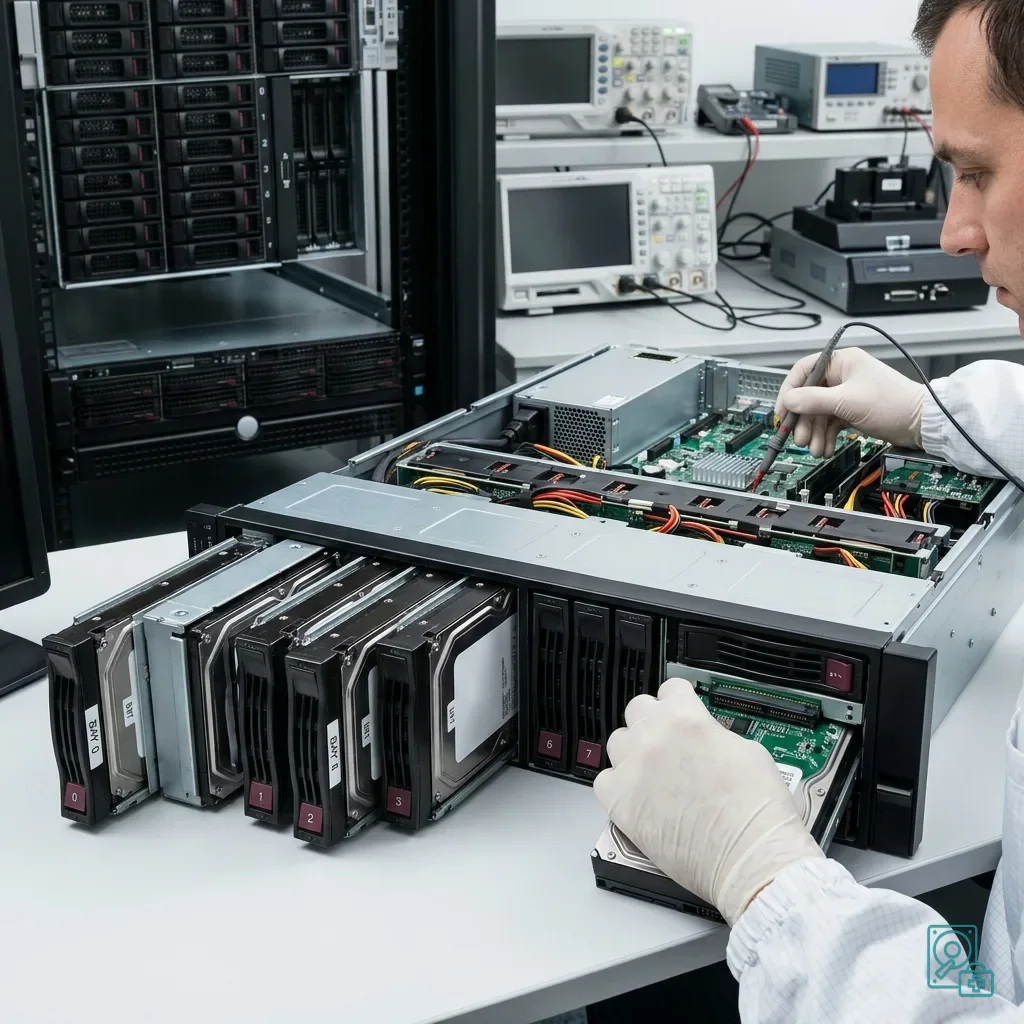
- L'ordre physique, les numéros de série et la position de chaque membre ;
- La configuration RAID, les métadonnées et les journaux du contrôleur ;
- L'heure des retraits, remplacements, imports et tentatives de reconstruction ;
- Les priorités métier et la dernière sauvegarde effectivement restaurée en test.
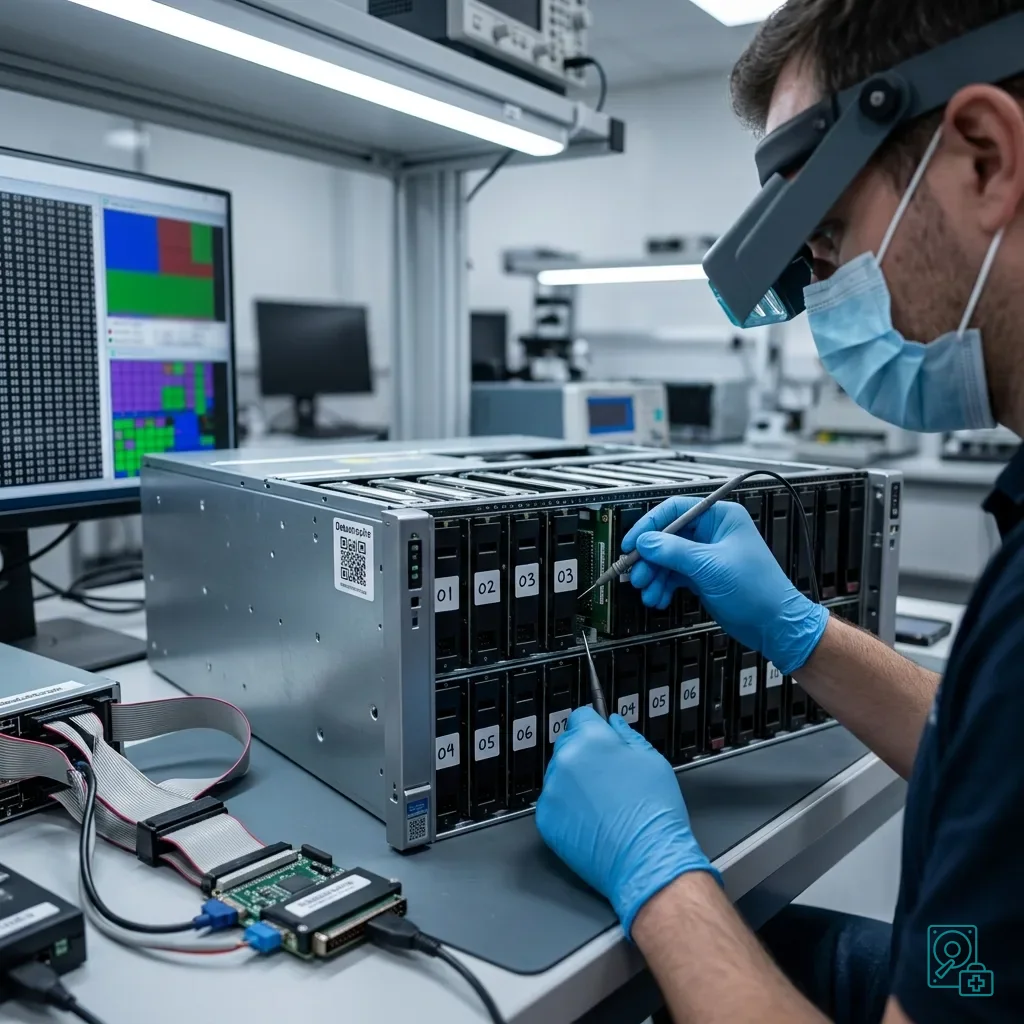
Si des supports sont instables, le laboratoire peut copier chaque membre en lecture contrôlée vers une destination distincte. Les reconstructions et montages s'effectuent sur des copies de travail, jamais sur les seuls disques sources.
RAID : redondance et limites explique pourquoi la redondance ne remplace pas la sauvegarde. Dans une panne répétitive, cette limite devient concrète : la tolérance de panne peut être dépassée très vite.
Périmètre du diagnostic : les alertes répétées sont étudiées entre supports, baies et composants communs. Les risques propres à une reconstruction RAID maintenue sous charge applicative forment un scénario distinct, à évaluer selon la charge I/O, l'état des membres et la priorité métier.
Il faut aussi éviter de confondre volume remonté et volume fiable. Un serveur peut redémarrer après reconstruction, mais contenir des fichiers incohérents ou des bases endommagées. Le contrôle qualité doit suivre la reprise.
Analyse
Prioriser services et données critiques
Dans un incident serveur, toutes les données n'ont pas le même poids. Une base métier, un dossier partagé, une messagerie locale, un volume de machines virtuelles ou des fichiers de production peuvent nécessiter des priorités différentes. Cette hiérarchie doit être claire avant le diagnostic.
La reprise d'activité peut être organisée sur une copie ou une sauvegarde, mais elle ne doit pas écraser les sources. Si l'équipe restaure rapidement pour redémarrer, il faut conserver les disques originaux et la configuration pour une analyse ultérieure.
Les dépendances applicatives comptent aussi. Une base sans journaux, une machine virtuelle sans descripteur ou un partage sans droits peut être partiellement exploitable mais difficile à remettre en production. Le diagnostic doit intégrer l'usage réel des données.
Un plan de récupération de données en entreprise complète cette logique en reliant priorités métier, responsabilités, sauvegardes vérifiées et critères de reprise. La technique gagne en efficacité quand les données à préserver sont déjà identifiées.
La communication interne doit rester factuelle. Dire "volume dégradé, reconstruction arrêtée, disques 2 et 4 instables, base comptable prioritaire" aide davantage qu'une formule vague. Cette précision évite les décisions contradictoires.
Analyse
Documenter la prévention
Après l'incident, la prévention doit remonter à la cause. Si la chaleur, le backplane ou l'alimentation étaient en jeu, remplacer les disques ne suffit pas. Il faut vérifier l'environnement, la supervision, la politique de sauvegarde et les procédures de reconstruction.
Les alertes doivent être testées. Une notification SMART ou RAID ignorée pendant plusieurs jours peut transformer une panne simple en incident complet. La prévention repose autant sur la réaction que sur la technologie.
Les sauvegardes doivent être restaurables. Une sauvegarde non testée, trop ancienne ou stockée dans le même environnement ne donne pas une reprise fiable. Le RAID protège contre certains scénarios, pas contre toutes les pertes.
Il est utile de tenir une fiche serveur : modèle, contrôleur, type de RAID, ordre des disques, capacité, micrologiciel, emplacement, services hébergés et procédures. En cas d'incident, cette fiche accélère les décisions sans imposer des essais dangereux.
Datastrophe peut analyser en laboratoire un serveur dont les disques présentent des pannes répétitives ou une reconstruction difficile. L'objectif est de qualifier les causes probables, préserver les supports et récupérer les données prioritaires sans relancer des opérations destructrices. Une intervention en salle blanche n'est envisagée que pour un disque magnétique présentant une atteinte mécanique compatible avec cette procédure, pas pour un défaut de RAID, de backplane ou d'alimentation.
Dans les environnements virtualisés, cette analyse doit inclure les volumes de machines virtuelles, snapshots et magasins de données. Une panne disque serveur peut se traduire par des fichiers virtuels incomplets, même si le système hôte redémarre encore.
Sources techniques primaires et limites
Le NIST SP 800-209 couvre le stockage fichier, bloc et objet, ainsi que réplication, protection et assurance de restauration. Il ne détermine ni la topologie, ni l’ordre des membres, ni la génération correcte du cache, des journaux ou des métadonnées du système reçu.
Faire qualifier le dossier « Disques serveur : diagnostic des pannes répétitives »
Transmettez à Datastrophe le système complet, tous les supports repérés, les contrôleurs et caches, les exports de configuration, les journaux, les clés autorisées et les services prioritaires. Les codes, clés et éléments d’authentification autorisés sont communiqués par un canal distinct ; ils ne sont jamais inscrits sur le support ni dans le colis.
Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son laboratoire, avec sa propre équipe. Le diagnostic et le devis sont gratuits. Le transport privé aller et retour est systématiquement pris en charge ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Chaque élément y est classé, dans cet ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Seuls les éléments recoverable_verified, dont le contenu a été contrôlé et jugé exploitable, sont présentés comme récupérables. Le client paie seulement après avoir accepté la liste et le prix ; la préparation du résultat et la restitution interviennent ensuite.
Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. La seule exception concerne une pièce rare, coûteuse et non remboursable : elle ne peut être commandée qu’après une proposition séparée, explicite et chiffrée.