
Analyse
La charge transforme une panne simple en incident critique
Un RAID serveur peut sembler stable tant que la charge reste normale. Lorsqu'un disque tombe et qu'une reconstruction démarre, l'équilibre change. Les disques restants lisent davantage, le contrôleur écrit en continu, les applications continuent parfois à solliciter le volume et les sauvegardes peuvent ajouter une couche de pression.
Cette situation explique pourquoi un RAID peut échouer "sous pression". Le problème ne vient pas uniquement du disque remplacé. La reconstruction révèle souvent des faiblesses déjà présentes : secteurs instables, chaleur, alimentation limite, backplane capricieux, contrôleur en erreur ou volume presque saturé.
Le symptôme visible peut être trompeur. Le serveur fonctionne encore, mais les temps de réponse augmentent, les journaux signalent des erreurs I/O, une reconstruction stagne ou un autre disque quitte le groupe RAID. Ces signes doivent être traités comme une alerte forte.
Mesurer la contention avant de décider
| Signal | Lecture prudente | Décision possible |
|---|---|---|
| Latence applicative seule | Concurrence entre production et rebuild | Réduire les I/O non essentielles |
| Erreurs média en hausse | Membre survivant instable | Suspendre et préserver les sources |
| Plusieurs tiroirs se déconnectent | Cause commune possible | Contrôler backplane, alimentation et contrôleur |
| Rebuild stable mais sauvegarde en échec | Reprise non garantie | Tester un point de restauration séparé |
Récupération de données sur RAID présente le service. Le diagnostic se concentre sur le moment délicat où la reconstruction se déroule alors que le serveur reste sollicité.
La bonne décision consiste à préserver l'état avant d'ajouter de nouvelles opérations. Une reconstruction forcée, une restauration au même emplacement ou un redémarrage non documenté peut rendre la suite plus difficile.
Il faut aussi tenir compte du calendrier métier. Une reconstruction lancée pendant une clôture comptable, une synchronisation massive ou une fenêtre de sauvegarde peut subir une charge très différente d'une période calme. Le moment choisi peut donc influencer le risque autant que l'opération elle-même.
Analyse
La reconstruction augmente les lectures et les écritures
Une reconstruction RAID n'est pas une opération neutre. Elle lit les membres survivants, reconstitue les blocs attendus depuis un miroir ou une parité, puis les écrit sur le disque de remplacement. Sur un volume chargé, cette activité s'ajoute aux requêtes applicatives, aux sauvegardes, aux scans et parfois aux machines virtuelles.
Si un membre survivant contient déjà des zones difficiles à lire, la reconstruction peut multiplier les accès à ces zones et consommer sa fenêtre de lecture encore disponible. Le serveur peut alors passer d'un volume dégradé à un volume incohérent ou inaccessible. Le risque augmente si plusieurs disques ont le même âge ou ont subi les mêmes conditions.
Il faut donc examiner les télémétries déjà disponibles avant de laisser la reconstruction aller trop loin, sans lancer de test exhaustif sur un membre instable. Les journaux SMART, contrôleur RAID, système et hyperviseur peuvent indiquer si le risque concerne un seul support ou l'ensemble de la baie.
Diagnostic des pannes serveur complète ce sujet. Les pannes rapprochées et les reconstructions difficiles doivent être lues comme un problème global, pas comme une simple série de remplacements.
Dans certains cas, il vaut mieux réduire la charge, figer l'état et copier les sources avant de reconstruire. La décision dépend des données, du niveau RAID, du nombre de disques instables et de l'urgence métier.
Le bridage n'est pas un diagnostic. Diminuer la priorité du rebuild peut rendre le serveur plus réactif, mais ne garantit pas que les membres survivants resteront lisibles. Une hausse des erreurs ou des déconnexions impose une nouvelle décision, pas seulement un réglage plus lent.
Analyse
Contrôleur, backplane et alimentation doivent être inclus
Un RAID serveur dépend aussi de composants communs. Le contrôleur RAID, le backplane, les câbles, l'alimentation et la ventilation peuvent provoquer des erreurs sur plusieurs disques. Si cette cause commune n'est pas identifiée, remplacer un disque ne règle pas l'incident.
Le backplane est souvent sous-estimé. Une baie peut perdre le contact, générer des erreurs intermittentes ou faire croire à une panne disque. Dans un contexte de reconstruction, ce type d'instabilité devient particulièrement dangereux.
La chaleur et l'alimentation comptent également. Un serveur en baie dense, une ventilation insuffisante ou une alimentation sollicitée peut multiplier les erreurs pendant les périodes de charge. La panne apparaît alors au moment où le RAID travaille le plus.
RAID : redondance et limites rappelle un point essentiel : la redondance n'est pas une sauvegarde. Elle ne protège pas contre une cause commune, une erreur humaine ou une reconstruction mal engagée.
Le diagnostic doit donc inclure la couche matérielle et la couche logique. Niveau RAID, ordre des disques, métadonnées, journaux et historique des remplacements sont nécessaires pour comprendre ce qui peut être préservé.
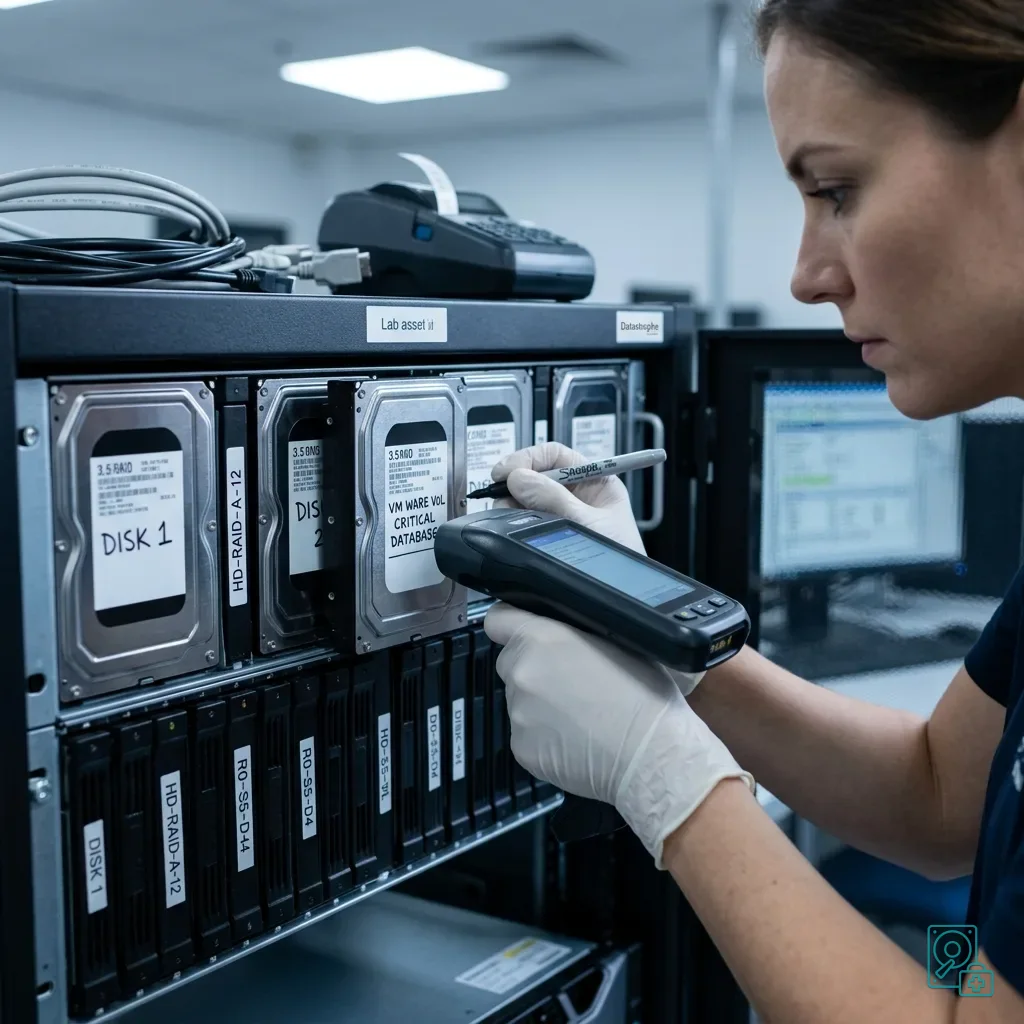
Une défaillance mécanique d'un disque dur peut nécessiter une intervention interne en salle blanche après diagnostic individuel. La reconstruction de la topologie RAID, elle, se réalise sur des acquisitions ou copies de travail, jamais en ouvrant les membres sains.
Analyse
Prioriser avant de relancer le volume
Quand le serveur porte des données critiques, il faut hiérarchiser. Base métier, machines virtuelles, dossiers clients, messagerie, applicatif de production ou archives n'ont pas la même urgence. La reconstruction technique ne doit pas faire oublier la valeur réelle des données.
La priorité doit devenir vérifiable :
- Configuration, journaux et fichiers nécessaires au redémarrage contrôlé ;
- Bases et machines virtuelles avec leur chaîne de dépendances ;
- Dossiers métier récents et périodes demandées ;
- Archives volumineuses qui peuvent attendre une acquisition plus lente.
Une reprise d'activité peut se préparer sur une sauvegarde ou une copie séparée, mais les disques originaux doivent rester disponibles pour le diagnostic. Restaurer au mauvais endroit ou réinitialiser le groupe RAID peut effacer des indices essentiels.
Il faut aussi documenter ce qui a déjà été tenté : disque remplacé, baie utilisée, heure de la reconstruction, pourcentage atteint, messages affichés, redémarrages, sauvegardes déclenchées. Cette chronologie évite de refaire la même opération dangereuse.
Perte de données serveur aborde les priorités métier. Dans un RAID sous charge, cette priorisation aide à choisir entre reprise rapide, copie technique et reconstruction contrôlée.
Un volume qui revient en ligne ne doit pas être considéré immédiatement comme sain. Il faut contrôler les fichiers prioritaires, les bases et les machines virtuelles avant de conclure que l'incident est terminé.
Analyse
Préparer une intervention maîtrisée
Avant une intervention, les informations utiles sont concrètes : modèle du serveur, contrôleur, niveau RAID, nombre de disques, ordre exact, disques remplacés, journaux, alertes et fichiers prioritaires. Plus ces éléments sont complets, moins le diagnostic repose sur des suppositions.
Il faut éviter de mélanger les disques ou de les tester un par un sans trace. Une inversion, une initialisation ou une importation forcée peut modifier les métadonnées nécessaires à la reconstruction logique.
Si le serveur doit rester partiellement disponible, cette contrainte doit être explicitée. Dans certains cas, il est possible d'organiser une reprise séparée tout en préservant les sources. Dans d'autres, l'arrêt contrôlé est la décision la moins risquée pour les données.
Datastrophe peut analyser un RAID serveur sous charge en conservant la priorité sur les données, pas sur le redémarrage immédiat du matériel. L'objectif est de distinguer la panne disque, la cause commune, la corruption logique et les limites réelles de récupération.
La prévention après incident doit rester simple : sauvegardes testées, alertes suivies, documentation de la configuration RAID, ventilation correcte et procédure de reconstruction connue. Ce sont ces éléments qui évitent de transformer une panne isolée en crise complète.
Si le RAID héberge des machines virtuelles, il faut ajouter les fichiers de VM, snapshots et banques de données à la liste de contrôle. Une reconstruction qui semble terminée côté contrôleur peut laisser une machine virtuelle incohérente si les écritures applicatives ont été interrompues.
Sources techniques primaires et limites
La documentation du noyau Linux sur les ensembles MD décrit superblocs, rôles, assemblage et états d’un RAID logiciel. Elle ne permet pas d’appliquer automatiquement une géométrie ou une génération à une baie propriétaire, et ne justifie aucune reconstruction sur les membres originaux.
Faire qualifier le dossier « RAID serveur sous charge : risques de reconstruction »
Transmettez à Datastrophe tous les membres actifs, retirés et de secours avec leur ordre de slot, le contrôleur et son cache, les configurations, les cartes d’erreurs et les volumes prioritaires. Les codes, clés et éléments d’authentification autorisés sont communiqués par un canal distinct ; ils ne sont jamais inscrits sur le support ni dans le colis.
Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son laboratoire, avec sa propre équipe. Le diagnostic et le devis sont gratuits. Le transport privé aller et retour est systématiquement pris en charge ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Chaque élément y est classé, dans cet ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Seuls les éléments recoverable_verified, dont le contenu a été contrôlé et jugé exploitable, sont présentés comme récupérables. Le client paie seulement après avoir accepté la liste et le prix ; la préparation du résultat et la restitution interviennent ensuite.
Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. La seule exception concerne une pièce rare, coûteuse et non remboursable : elle ne peut être commandée qu’après une proposition séparée, explicite et chiffrée.