
Analyse
Un SSD de NAS n'a pas les mêmes contraintes qu'un SSD de poste
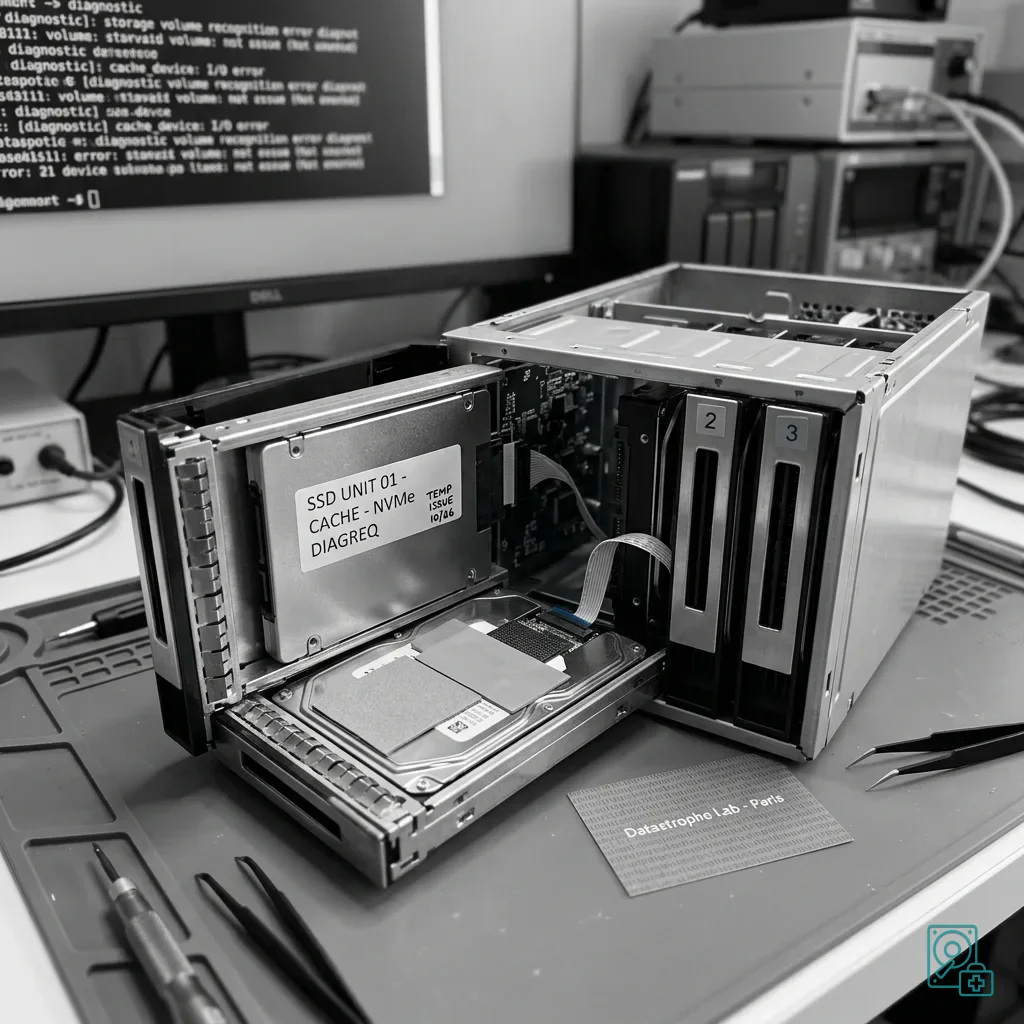
Un SSD installé dans un NAS travaille souvent dans un environnement plus dense qu'un ordinateur personnel. Il peut servir de volume principal, de cache de lecture, de cache d'écriture ou de support pour machines virtuelles. Ces usages sollicitent fortement le contrôleur et les cellules mémoire.
La chaleur est un signal à prendre au sérieux, mais elle ne suffit pas à expliquer la panne. Elle peut venir d'une baie mal ventilée, d'un SSD inadapté à l'usage, d'écritures continues, d'un micrologiciel instable, d'une reconstruction RAID ou d'un cache saturé.
Le risque pour les données dépend du rôle du SSD. Un cache en lecture n'a pas les mêmes implications qu'un cache en écriture. Un volume SSD principal n'a pas les mêmes priorités qu'un cache attaché à un RAID de disques durs.
Identifier la fonction avant d'interpréter la température
| Rôle déclaré | Exposition possible des données | Information à conserver |
|---|---|---|
| Cache de lecture | Blocs recopiés depuis le volume principal | Mode, association au volume et état avant incident |
| Cache d'écriture | Écritures acquittées mais pas encore reportées, selon l'implémentation | Paire de cache, protection électrique et journaux |
| Volume SSD | Fichiers, métadonnées ou machines virtuelles directement stockés | Ordre, RAID, chiffrement et système de fichiers |
| Tiering | Blocs déplacés entre plusieurs classes de stockage | Politique de placement et métadonnées du pool |
Ces catégories ne se déduisent ni du format du SSD ni de son emplacement dans la baie. Le même module peut changer de fonction après une migration ou une mise à jour. Il faut lire la configuration et les journaux disponibles avant de conclure qu'il est remplaçable.
Point d'arrêt — un avertissement thermique n'autorise pas à retirer le SSD. Documentez d'abord son rôle et l'état du pool ; un cache d'écriture ou un niveau de tiering ne se traite pas comme une simple copie accélérée.
La récupération de données RAID présente les cas NAS et RAID. Le périmètre isole ici le rôle du SSD, car il impose une lecture différente de celle des disques mécaniques.
Il faut éviter de remplacer le SSD ou de reconstruire le volume sans connaître sa fonction. Une opération qui semble logique côté matériel peut modifier la cohérence du volume ou perdre une donnée en attente dans le cache.
Le contexte d'installation compte aussi. Un SSD placé près d'une alimentation, dans un boîtier compact ou derrière une façade peu ventilée peut atteindre des températures élevées sans que l'utilisateur voie immédiatement le problème. Les alertes du NAS doivent donc être conservées et lues avant intervention.
Analyse
Le cache SSD peut compliquer la récupération
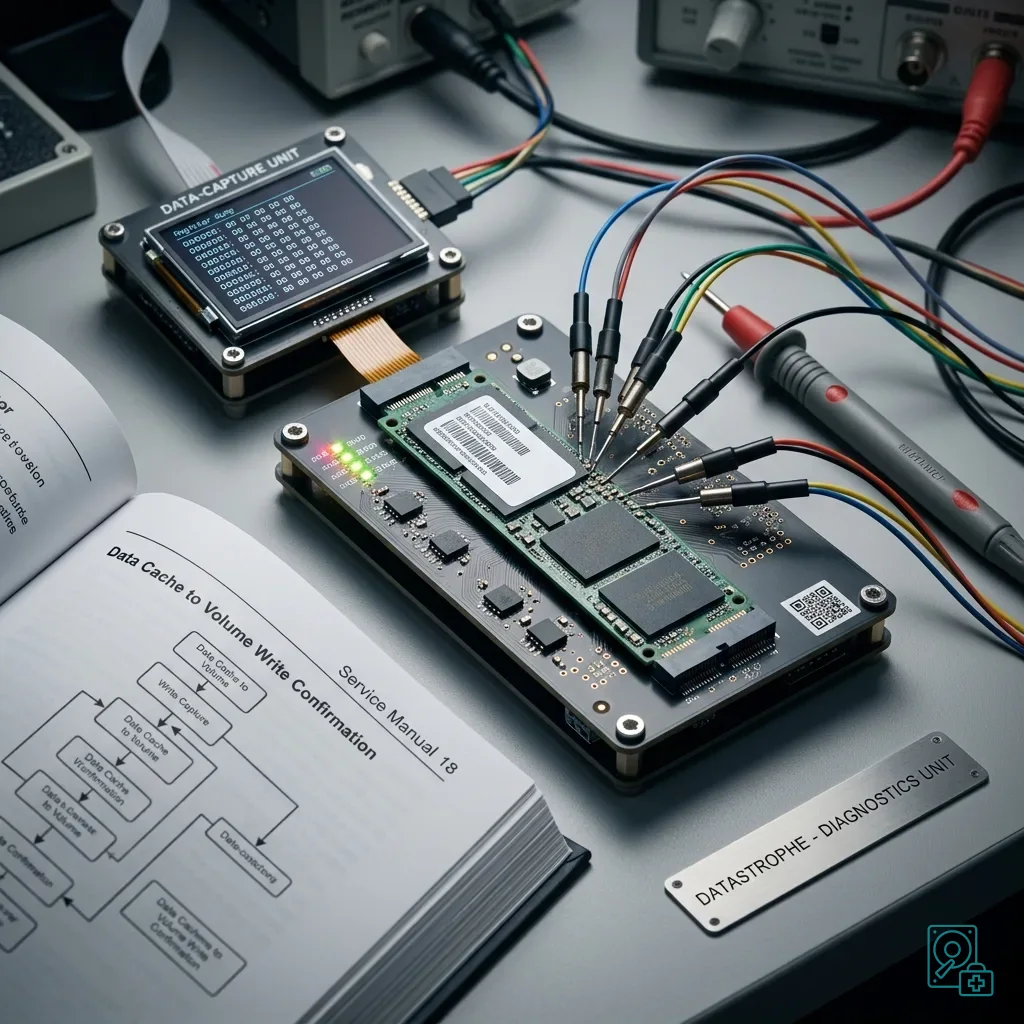
Dans un NAS, le cache SSD peut accélérer les accès, mais il ajoute une couche. Si le cache est en écriture, certaines données peuvent transiter par le SSD avant d'être confirmées sur le volume principal. En cas de panne, la cohérence dépend de cette configuration.
Il faut donc identifier le rôle exact du SSD : cache lecture, cache écriture, stockage, tiering, volume système ou support de machines virtuelles. Les journaux du NAS, la configuration et l'ordre des disques peuvent être déterminants.
La portée dépend aussi du mode retenu par le constructeur. Un cache de lecture est normalement reproductible depuis le volume principal. Un cache d'écriture peut, selon les garanties d'acquittement et de destage, contenir une partie de l'état le plus récent. Une paire de SSD, une protection par condensateur ou un onduleur réduisent certains risques sans prouver que toutes les écritures ont atteint le volume.
Une suppression du cache, une réinitialisation ou une reconstruction peut effacer des informations utiles. Même si le NAS propose une réparation automatique, il faut comprendre ce qui sera écrit et sur quel volume.
Risques de récupération sur NAS montre pourquoi les NAS sont souvent traités trop vite comme de simples boîtiers. Avec un cache SSD, cette simplification devient encore plus risquée.
La récupération doit intégrer toutes les couches : SSD, disques principaux, RAID, snapshots, partages, machines virtuelles et sauvegardes. Analyser uniquement le support qui chauffe peut être insuffisant.
Le dossier technique doit notamment réunir :
- Les alertes de température et les heures auxquelles elles apparaissent ;
- Le mode du cache et, s'il est appairé, l'identité des deux SSD ;
- L'état du pool, des volumes et des tâches de reconstruction ;
- Les arrêts électriques, mises à jour et remplacements récents ;
- Les dossiers, bases ou machines virtuelles prioritaires.
Analyse
Chaleur, endurance et écritures continues se cumulent
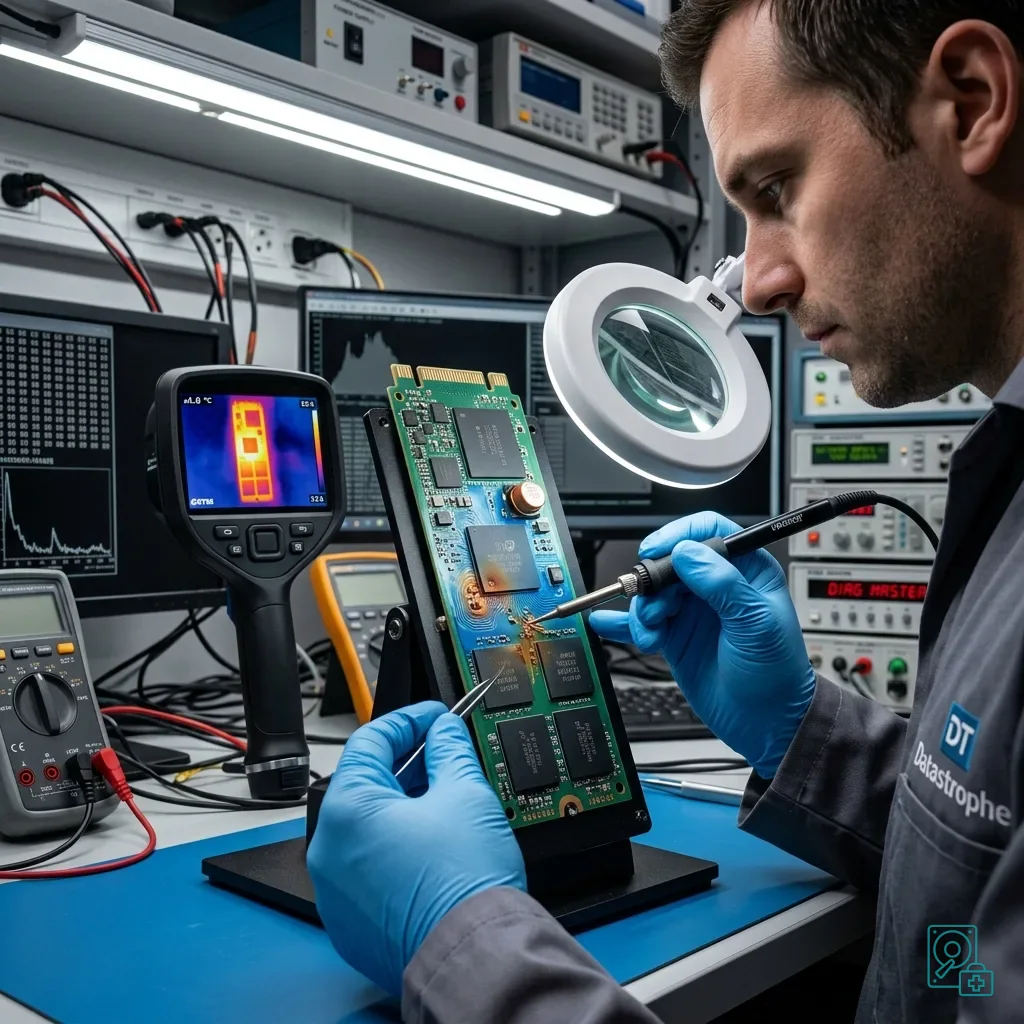
Un SSD n'a pas de pièces mécaniques, mais il n'est pas invulnérable. Les écritures continues, la chaleur, la saturation et certaines charges de cache peuvent user ou déstabiliser le support. Un NAS qui journalise, synchronise ou héberge des VM peut écrire beaucoup plus qu'un poste classique.
Les signes d'alerte sont concrets : ralentissement, cache désactivé, volume dégradé, erreurs SMART, température élevée, SSD absent, reconstruction qui démarre, snapshots bloqués ou fichiers incohérents. Il faut les lire ensemble.
La chaleur peut aussi toucher plusieurs supports en même temps. Si la baie est mal ventilée, le problème peut concerner le SSD, les disques voisins et l'alimentation. Remplacer un seul élément ne suffit pas toujours.
La récupération des SSD NVMe explique les contraintes de contrôleur, TRIM et mémoire flash. Dans un NAS, ces contraintes se combinent avec le RAID et le cache.
Il faut éviter les tests prolongés sur un SSD instable. Un scan intensif, une reconstruction ou une copie non contrôlée peut consommer les dernières lectures utiles et masquer la chronologie de la panne.
Distinguer ralentissement thermique et perte de cohérence
Le throttling réduit les performances pour contenir la température ; il ne prouve pas, à lui seul, une perte de données. Le seuil devient critique lorsque la hausse thermique coïncide avec des erreurs, des disparitions, des écritures non destagées ou un volume qui change d'état. La corrélation entre température, charge et journaux est plus utile qu'une valeur isolée.
Un refroidissement brutal n'est pas un diagnostic. Il peut rendre le SSD visible quelques minutes sans expliquer la cause ni stabiliser les autres membres. Si une fenêtre de lecture existe, elle doit servir à une acquisition priorisée, pas à remettre le NAS en production.
Analyse
Préserver le NAS avant toute reconstruction
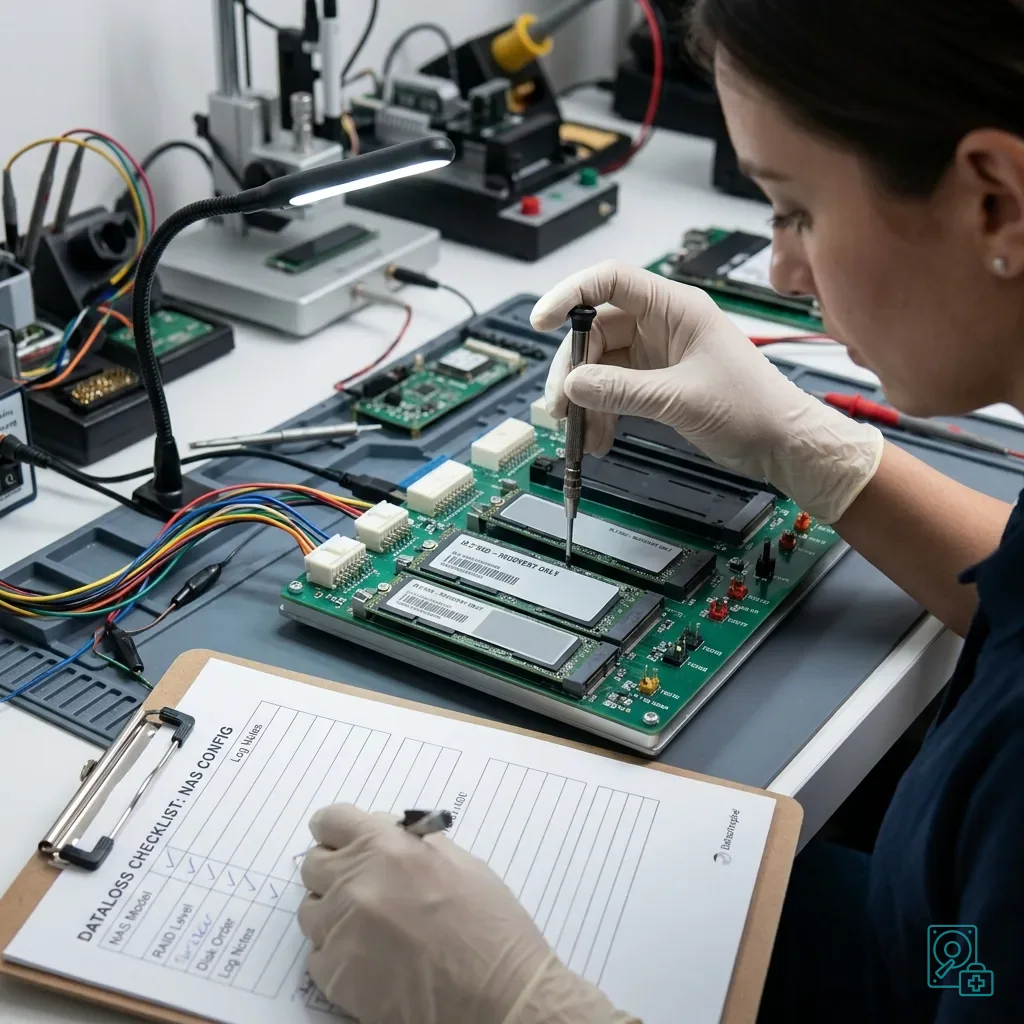
Avant d'intervenir, il faut conserver la configuration du NAS : modèle, version, rôle du SSD, ordre des disques, niveau RAID, journaux, alertes et opérations déjà tentées. Ces informations évitent de reconstruire à partir d'hypothèses.
Si le NAS propose de supprimer le cache ou de réintégrer un SSD, il faut attendre. Une confirmation trop rapide peut modifier le volume principal. La priorité est de savoir si le cache contient une donnée utile ou seulement des copies accélérées.
Les sauvegardes doivent être vérifiées sur un support séparé. Restaurer directement vers le NAS en incident peut écraser des éléments nécessaires au diagnostic. La reprise doit rester distincte de la récupération.
RAID serveur sous charge complète cette prudence côté reconstruction. Dès que plusieurs couches interagissent, la charge ajoutée peut aggraver la situation.
La liste des données prioritaires est indispensable. Dossiers partagés, bases, photos, vidéos, sauvegardes de postes ou machines virtuelles ne demandent pas le même contrôle. La récupération doit viser ce qui a une valeur réelle.
Le triage suit un ordre contrôlable :
- Figer les tâches automatiques et photographier la baie ;
- Exporter la configuration et les journaux sans réécrire le pool ;
- Vérifier les sauvegardes sur une destination séparée ;
- Acquérir les supports utiles avant toute reconstruction risquée ;
- Reconstruire et valider les fichiers sur des copies.
En laboratoire, l'analyse distingue la panne électronique du SSD, la cohérence du cache et la structure RAID. La salle blanche n'est pas un traitement du SSD ; elle n'intervient que si un disque dur mécanique du NAS présente une atteinte interne justifiant son ouverture.
Analyse
Prévenir les récidives sur NAS SSD
Après incident, la prévention doit porter sur la configuration. Il faut vérifier que le SSD choisi correspond à l'usage, que la ventilation est correcte, que les alertes température sont suivies et que les sauvegardes sont testées.
Le cache doit être compris par l'équipe qui administre le NAS. Savoir s'il est en lecture ou en écriture change la réaction en cas de panne. Une procédure écrite évite de cliquer trop vite sur une réparation proposée par l'interface.
Les snapshots et sauvegardes doivent être distincts. Un snapshot local sur le même NAS ne protège pas contre une panne globale du boîtier, une corruption ou une erreur de reconstruction. Il aide parfois, mais ne remplace pas une copie saine.
La recette après maintenance doit vérifier le cache autant que les fichiers : températures sous charge normale, absence d'erreurs, destage terminé, redémarrage contrôlé et restauration d'un échantillon depuis la sauvegarde. Un voyant vert ne valide ni la chronologie du pool ni l'exploitabilité des données.
Datastrophe peut analyser un NAS avec SSD en cache, SSD principal ou volume hybride. Le diagnostic cherche à préserver l'état, comprendre le rôle du SSD et restituer les fichiers utiles sans confondre redémarrage du NAS et récupération réussie.
Un NAS équipé de SSD peut être performant, mais il reste un système de stockage complexe. Sa protection dépend moins du type de support que de la configuration, des sauvegardes et des décisions prises au moment de l'incident.
Si le NAS héberge des caméras, machines virtuelles ou sauvegardes de postes, les écritures peuvent être continues. Cette charge doit être intégrée au choix du SSD et à la stratégie de récupération, car elle influence l'usure comme la chaleur.
Sources techniques primaires et limites
La note technique KIOXIA sur l’ECC NAND explique le rôle de la correction d’erreurs dans la lecture des cellules. Elle ne révèle ni la traduction propriétaire du contrôleur, ni les paramètres d’appairage, de calibration ou de chiffrement du support reçu, et ne prouve pas la cohérence des fichiers reconstruits.
Faire qualifier le dossier « SSD de NAS : surchauffe, cache et données »
Transmettez à Datastrophe le support et sa carte hôte, les alimentations et adaptateurs, la chronologie des détections, les paramètres d’usage connus et la liste des données prioritaires. Les codes, clés et éléments d’authentification autorisés sont communiqués par un canal distinct ; ils ne sont jamais inscrits sur le support ni dans le colis.
Datastrophe réalise directement le diagnostic, les contrôles d’intégrité et la récupération dans son laboratoire, avec sa propre équipe. Le diagnostic et le devis sont gratuits. Le transport privé aller et retour est systématiquement pris en charge ; le transporteur déplace uniquement le colis scellé, sans accéder aux données ni les traiter.
Avant tout paiement, le client reçoit le prix proposé et une liste contrôlée. Chaque élément y est classé, dans cet ordre, recoverable_verified, partial, detected_unverified ou unrecoverable. Seuls les éléments recoverable_verified, dont le contenu a été contrôlé et jugé exploitable, sont présentés comme récupérables. Le client paie seulement après avoir accepté la liste et le prix ; la préparation du résultat et la restitution interviennent ensuite.
Si aucune donnée exploitable n’est vérifiée, si la récupération échoue ou si le client refuse la liste ou le prix, aucun frais standard n’est dû. La seule exception concerne une pièce rare, coûteuse et non remboursable : elle ne peut être commandée qu’après une proposition séparée, explicite et chiffrée.