
Diagnosi
I guasti ripetuti hanno spesso una causa comune
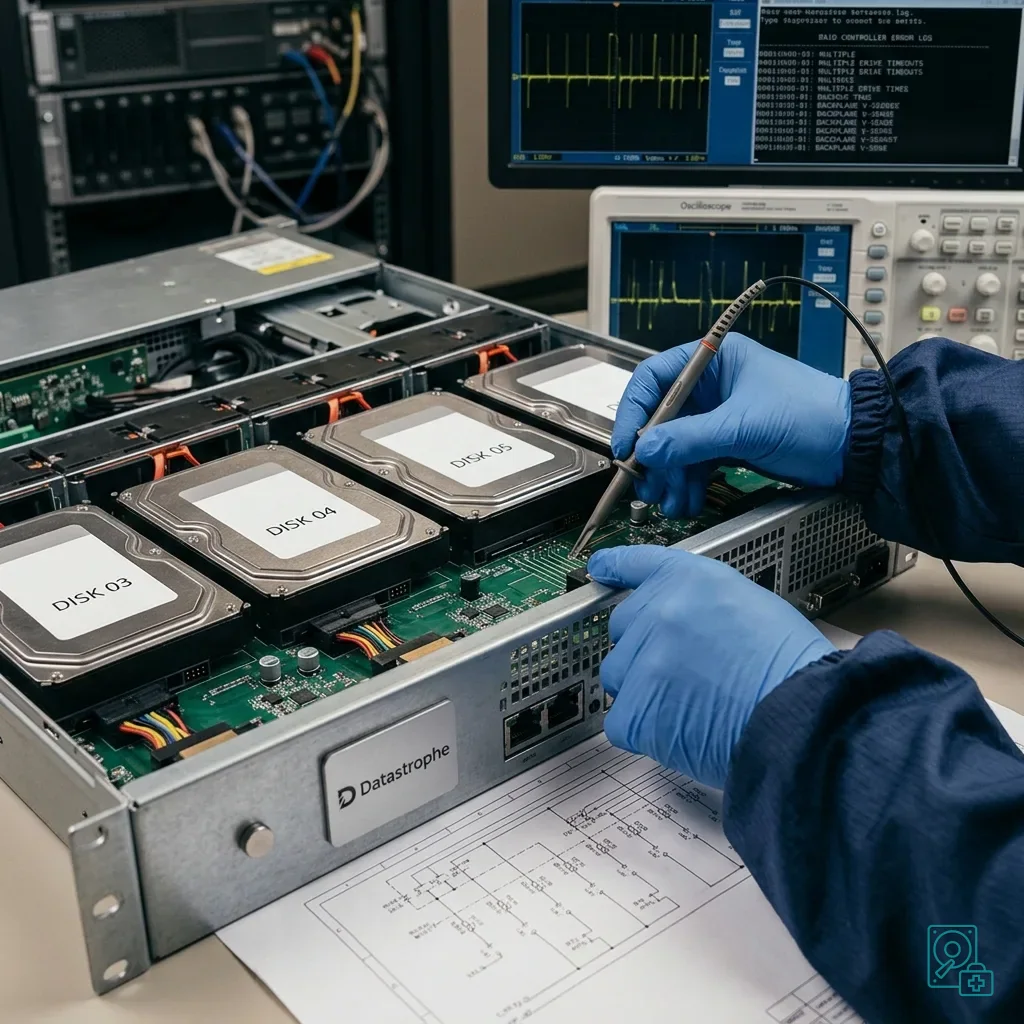
Quando due o più dischi segnalano errori nello stesso intervallo, la coincidenza va dimostrata e non data per scontata. Ora, baia, seriale, tipo di errore e carico del server vengono riuniti in una cronologia unica per riconoscere eventi condivisi.
Unità della stessa serie, età e lotto possono raggiungere insieme una fase di usura. Tuttavia, sostituirle senza controllare l'ambiente può esporre anche i nuovi dischi alla stessa temperatura, tensione instabile o sollecitazione meccanica.
Il raffreddamento viene valutato attraverso temperature per baia, velocità delle ventole, filtri, pressione dell'aria e disposizione dei cavi. Un sensore medio può nascondere un punto caldo vicino a controller, alimentatore o unità centrali.
Vibrazioni di ventole, telaio, unità adiacenti o rack possono aumentare errori e latenze sotto carico. La correlazione con velocità di rotazione, ricostruzioni e interventi fisici aiuta a distinguere un difetto del disco da una sollecitazione comune.
Il servizio di recupero dati da server preserva ordine, configurazione e contenuto prima di cambiare componenti. Ogni supporto viene trattato come fonte distinta, anche se il controller lo ha già marcato come failed o foreign.
I server con dati critici richiedono inoltre una decisione aziendale: quali servizi possono essere ricreati e quali dati sono unici. La priorità operativa non deve obbligare a ricostruire sulla sola copia dell'array.
Diagnosi
Verificare RAID, backplane e alimentazione
Il controller RAID viene controllato per firmware, cache, batteria, eventi, timeout e cambi di configurazione. Una cache non protetta o un riavvio durante le scritture può lasciare parità e dati non allineati pur mostrando dischi fisicamente sani.
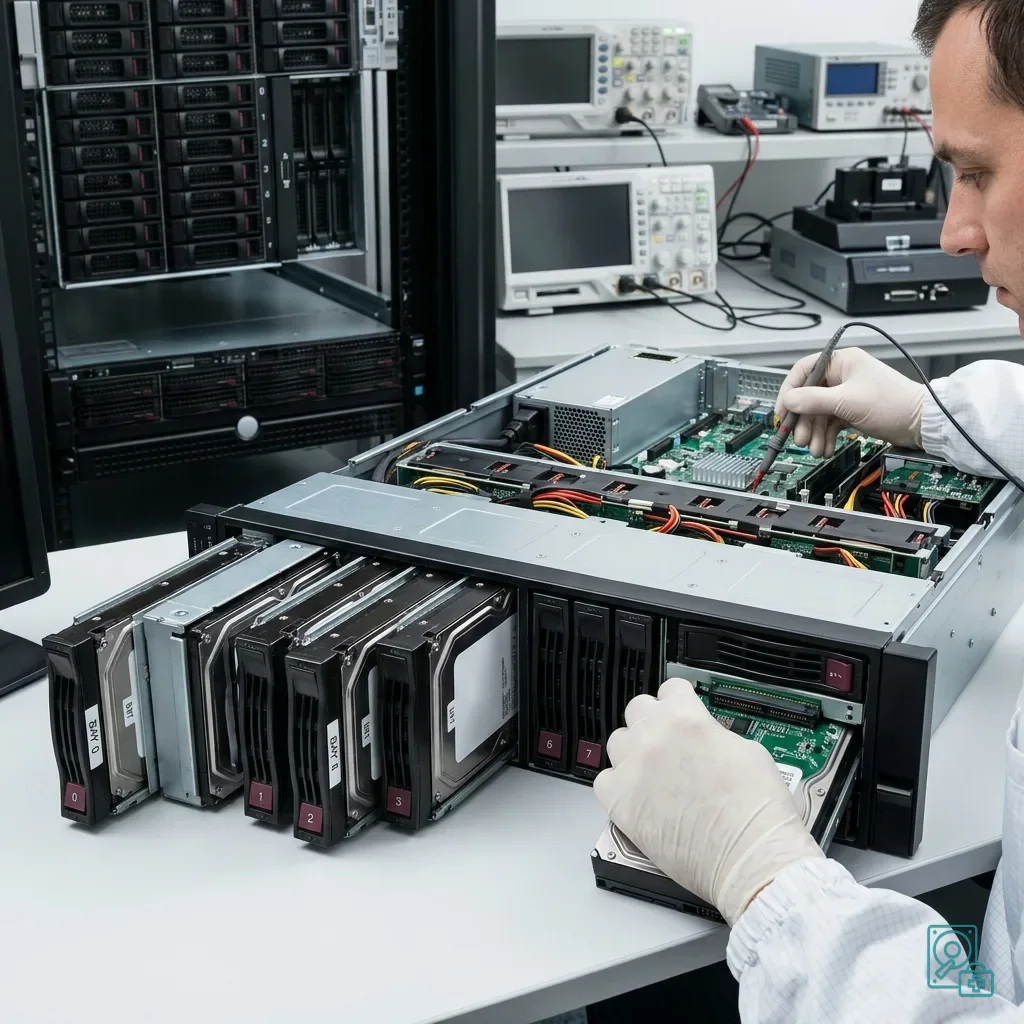
Backplane, expander, cavi e connettori possono causare disconnessioni intermittenti. Si confrontano errori per porta e per seriale: se il problema segue la baia anziché il disco, sostituire l'unità non elimina la causa.
Le linee di alimentazione vengono misurate sotto carico, includendo alimentatori ridondanti, UPS e distribuzione nel rack. Cadute, ripple o connettori surriscaldati possono provocare reset simultanei che i log interpretano come più guasti separati.
Temperature, vibrazioni e polvere sono confrontate tra zone della baia. Segni di ossidazione, residui o manutenzione recente completano l'ispezione, senza spostare i dischi prima di aver fotografato ordine e collegamenti.
I dati SMART già registrati mostrano settori riallocati, pending, errori CRC, temperatura e ore di servizio. Non si avviano test estesi sull'array degradato: i contatori vengono letti nel contesto e non usati come certificato assoluto di salute.
La ridondanza RAID e i suoi limiti vengono considerati nella diagnosi. Parità e mirror tollerano alcuni guasti, ma non correggono un controller errato, una causa comune o la corruzione già scritta su tutte le copie.
Diagnosi
Evitare ricostruzioni in sequenza
Ogni rebuild legge intensamente tutte le unità rimaste e scrive sul disco sostitutivo. Se un altro supporto è lento o contiene settori deboli, la ricostruzione può trasformare un array degradato ma leggibile in un volume incompleto.
Non si reinseriscono dischi espulsi in ordine casuale e non si accetta l'inizializzazione proposta dal controller. Stati foreign, stale e online descrivono una cronologia da interpretare; l'etichetta automatica non stabilisce quale unità contenga i blocchi più recenti.
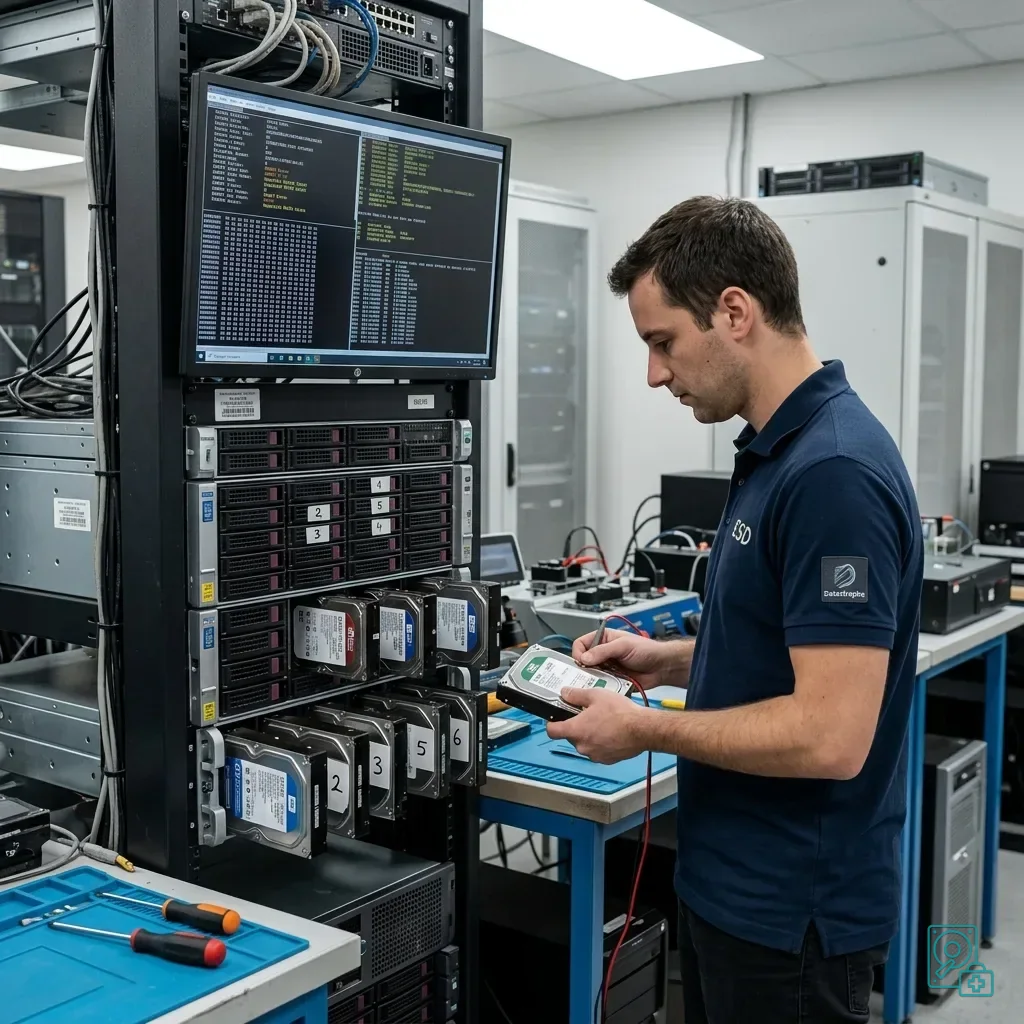
Ordine delle baie, seriali, hot spare, geometria, stripe, parità e offset vengono esportati o fotografati. Ogni disco è acquisito singolarmente con mappa e checksum, mantenendo associati errori e intervalli mancanti.
La ricostruzione avviene su immagini protette, confrontando più combinazioni quando necessario. File system, log e dati noti verificano l'ipotesi; una percentuale di rebuild completata non prova che ordine e parità siano corretti.
Le automazioni di patrol read, scrub, tiering e sostituzione vengono sospese sul perimetro. Un solo responsabile autorizza le operazioni, così strumenti e tecnici non avviano letture o scritture concorrenti sui supporti fragili.
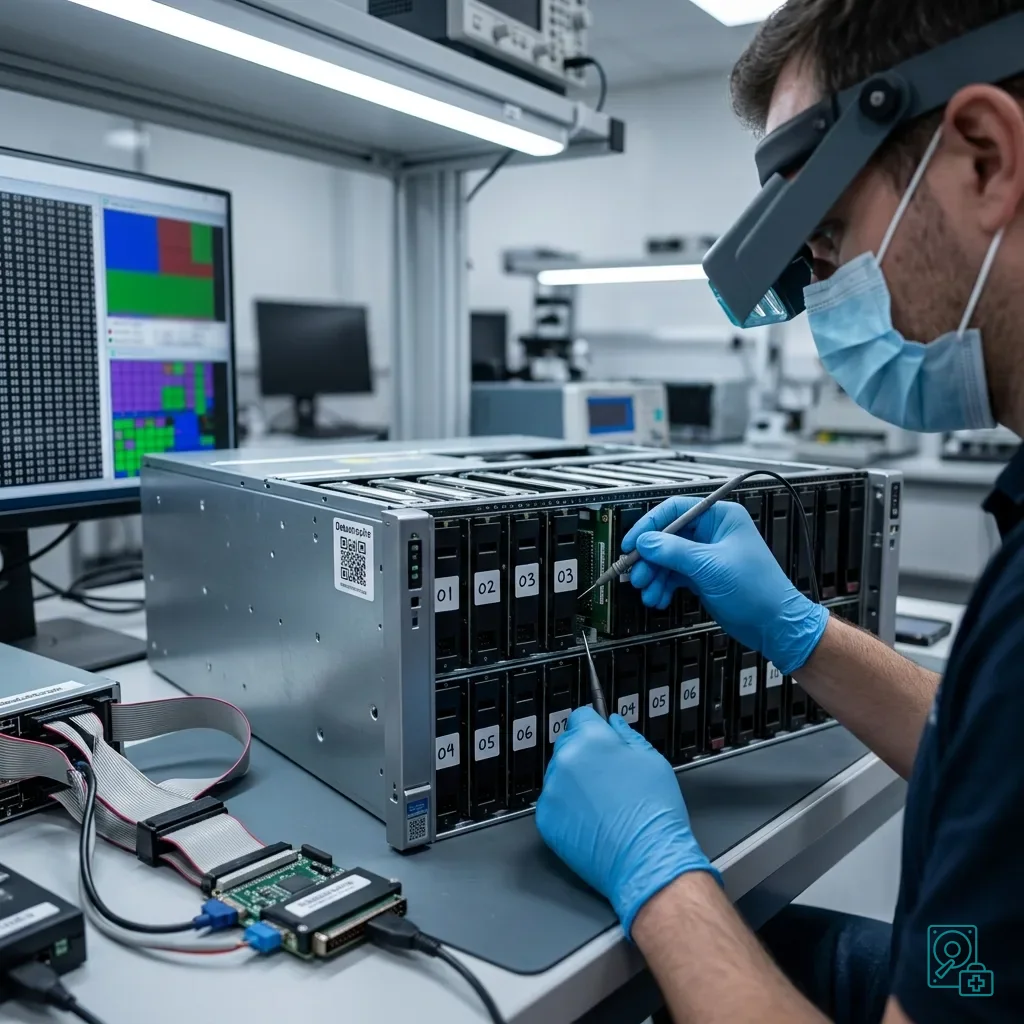
Diagnosi
Dare priorità a servizi e dati critici
L'inventario distingue sistemi operativi ricreabili, configurazioni, database, macchine virtuali, condivisioni e archivi. Per ogni insieme indica proprietario, dipendenze, ultima copia verificata e impatto di una restituzione parziale.
Percorsi, nomi, versioni, intervalli temporali e quantità attese trasformano la priorità in un criterio tecnico. Database e applicazioni richiedono anche log, chiavi, file di configurazione e versione software necessaria alla validazione.
Le aree del RAID che contengono dati unici possono guidare l'ordine di estrazione, senza costringere subito una ricostruzione completa. Copie di backup già sane riducono il carico sui dischi e permettono di concentrare i passaggi sulle lacune reali.
La continuità del servizio usa hardware e storage alternativi. I supporti originali restano fuori produzione, mentre le copie recuperate vengono montate in sola lettura o su rete isolata prima di una migrazione controllata.
La restituzione distingue file completi, parziali, corrotti e non verificabili. Il rapporto collega ogni limite a dischi mancanti, settori assenti, geometria incerta o scritture del rebuild, evitando di presentare il solo volume estratto come prova di successo.
Diagnosi
Documentare la prevenzione
Il registro conserva modello, seriale, baia, data di installazione, firmware e sostituzioni. Errori, temperature e interventi sono correlati nel tempo, così una tendenza comune emerge prima che più unità vengano espulse nello stesso giorno.
Soglie su temperatura, errori CRC, latenze, reset e stato della cache generano azioni precise. Ogni allarme ha un responsabile e una regola di arresto; notifiche ripetute senza escalation non costituiscono monitoraggio efficace.
Manutenzione di ventole, filtri, alimentazione, backplane e firmware segue finestre documentate. Le modifiche vengono eseguite una alla volta con controllo prima e dopo, permettendo di attribuire eventuali anomalie a un cambiamento concreto.
Il piano aziendale di recupero dei dati include configurazione RAID, inventario delle baie, credenziali e contatti. Stabilisce anche dove creare immagini e chi può autorizzare il fermo senza attendere una nuova emergenza.
Backup indipendenti e versionati vengono provati su infrastruttura isolata. Il test verifica database, permessi e dipendenze, misura il tempo di ripresa e impedisce che ridondanza del server e backup condividano lo stesso controller o lo stesso sito.
Dopo un incidente, la causa viene chiusa soltanto con evidenze: misure elettriche, log, componente sostituito e periodo di osservazione. I dischi recuperati non tornano nell'array e i dati validati migrano su una piattaforma sana e monitorata.
Diagnosi
Fonti tecniche primarie e limiti
Perimetro documentale — server guasti ripetuti diagnosi: Per dischi server guasti ripetuti diagnosi, le fonti primarie utilizzate sono csrc.nist.gov. Evidenza fisica — server guasti ripetuti diagnosi: Definiscono i concetti pertinenti di conservazione, struttura di archiviazione e convalida, ma non dimostrano lo stato fisico effettivo, il comportamento del controller, la disponibilità delle chiavi o la coerenza applicativa del dispositivo ricevuto. Evidenza del controller — server guasti ripetuti diagnosi: Questi aspetti richiedono misure sul gruppo originale e verifiche su copie.
Diagnosi
Richiedere una diagnosi controllata
Gruppo completo — server guasti ripetuti diagnosi: Per diagnosticare dischi server guasti ripetuti diagnosi, fornire il dispositivo o il gruppo completo, alimentatori e interfacce associati, ordine ed etichette dei membri, cronologia dei sintomi ed elenco preciso dei dati prioritari. Cronologia dell’incidente — server guasti ripetuti diagnosi: Le credenziali autorizzate vanno trasmesse tramite un canale protetto separato; non riavviare la sorgente solo per ottenere una nuova schermata.
Responsabilità del laboratorio — server guasti ripetuti diagnosi: Datastrophe esegue direttamente diagnosi, controlli di integrità e recupero nel proprio laboratorio con il proprio personale. Diagnosi gratuita — server guasti ripetuti diagnosi: Diagnosi e preventivo sono gratuiti. Limite del trasporto — server guasti ripetuti diagnosi: Il trasporto privato di andata e ritorno è incluso; il corriere sposta esclusivamente il pacco sigillato e non accede né tratta i dati.
Elenco controllato — server guasti ripetuti diagnosi: Prima di qualsiasi pagamento, il cliente riceve il prezzo proposto e un elenco verificato. Classi di verifica — server guasti ripetuti diagnosi: Ogni elemento è classificato, nell’ordine, come recoverable_verified, partial, detected_unverified o unrecoverable. Momento del pagamento — server guasti ripetuti diagnosi: Solo gli elementi recoverable_verified, aperti e giudicati utilizzabili, vengono presentati come recuperabili. Esito non verificato — server guasti ripetuti diagnosi: Il pagamento avviene dopo l’accettazione dell’elenco e del prezzo.
Esito non verificato — server guasti ripetuti diagnosi: Se non viene verificato alcun dato utilizzabile, il recupero non riesce oppure il cliente rifiuta elenco o prezzo, non è dovuto alcun costo standard. Ricambio eccezionale — server guasti ripetuti diagnosi: L’unica eccezione riguarda un ricambio raro, costoso e non rimborsabile, ordinabile soltanto dopo l’accettazione di una proposta separata, esplicita e quantificata.