
Diagnosi
Capire quando il carico trasforma il degrado in crisi
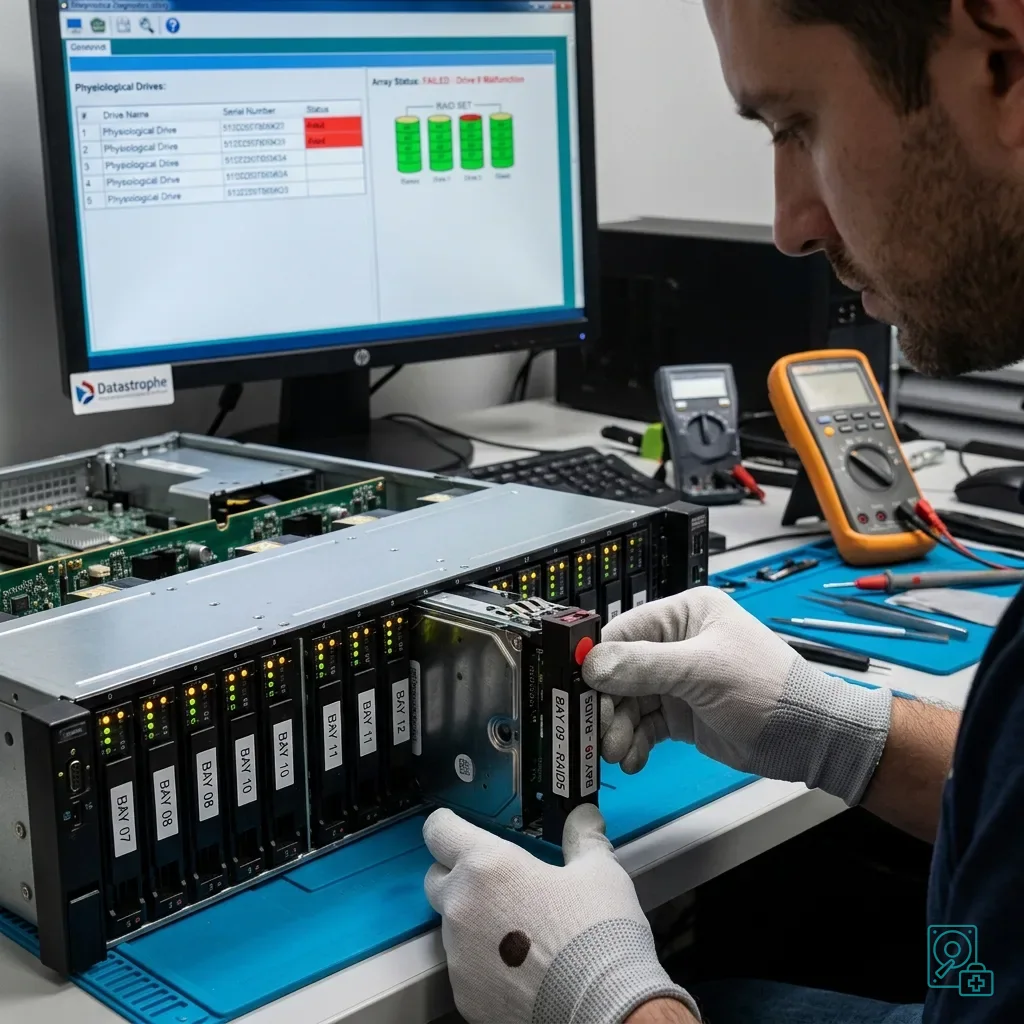
Un RAID può apparire stabile finché il traffico resta ordinario. Quando un membro cade e parte il rebuild, gli altri leggono di più, il controller scrive continuamente e le applicazioni continuano a chiedere I/O.
La pressione rivela debolezze preesistenti: settori instabili, calore, alimentazione al limite, backplane intermittente, controller in errore o volume quasi saturo. Il disco sostituito può essere soltanto il primo sintomo.
Segnali come latenza crescente, errori I/O, ricostruzione ferma e un altro drive espulso sono allarmi forti. Il fatto che il server risponda ancora non dimostra che il volume sia sicuro.
Il servizio di recupero dati da sistemi RAID riguarda l'intervento sul set. Qui la decisione critica è fermare o ridurre il carico prima che la ricostruzione consumi il margine residuo.
Lo stato viene preservato prima di aggiungere operazioni. Rebuild forzato, restore sulla stessa destinazione e riavvio non documentato possono cancellare versioni e metadati utili.
Anche il calendario aziendale conta. Chiusura contabile, replica massiva e finestra di backup generano pressioni molto diverse da una notte senza utenti e possono cambiare il rischio tecnico.
Diagnosi
Misurare il costo I/O della ricostruzione
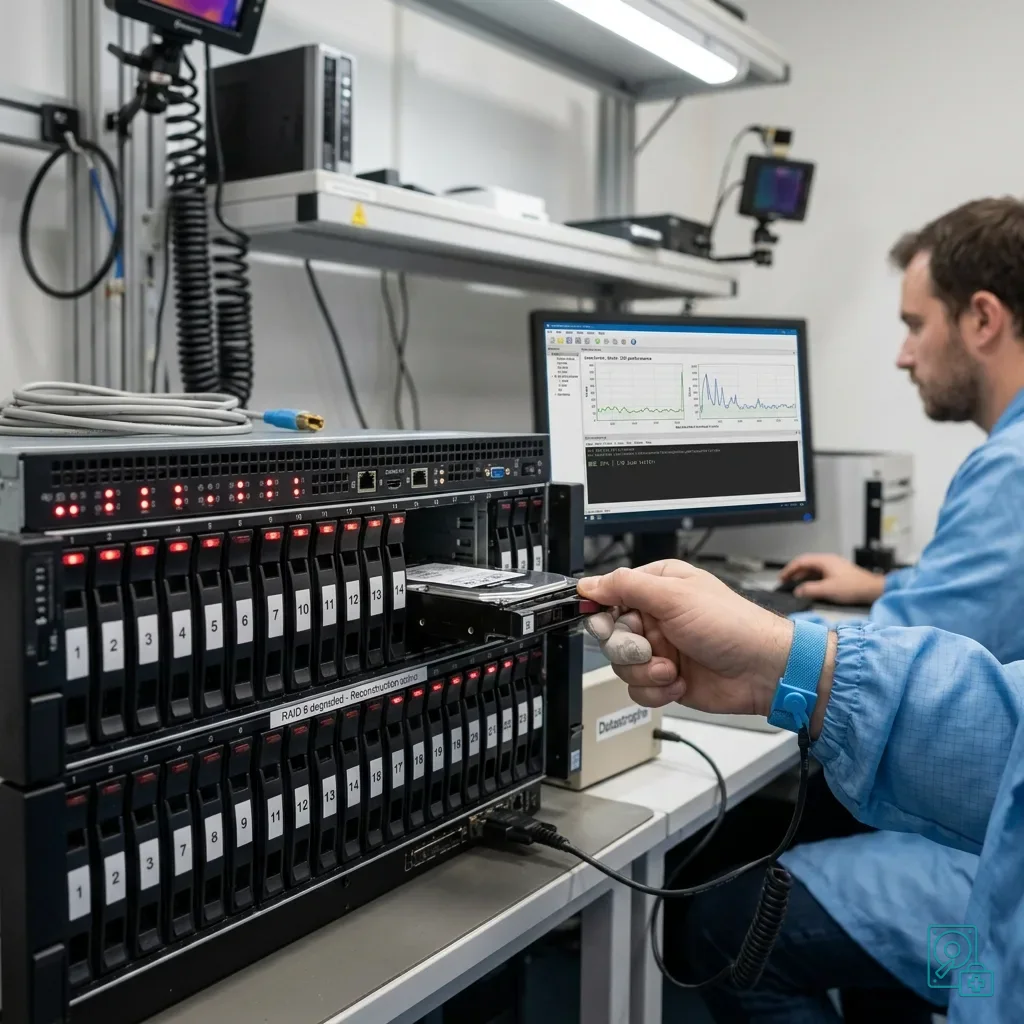
Il rebuild legge i membri superstiti, calcola dati o parità e scrive il nuovo disco. A questo flusso si sommano query, VM, scansioni, snapshot e copie che il server continua a eseguire.
Un drive con aree deboli può superare il proprio limite durante la lettura completa. L'array passa allora da degradato ad incoerente o offline, soprattutto se i membri hanno età e condizioni simili.
Log SMART, controller, sistema e hypervisor vengono correlati prima di lasciare avanzare la ricostruzione. L'obiettivo è capire se il rischio riguarda un supporto o l'intera enclosure.
L'analisi delle rotture ripetute sui dischi server mostra perché guasti ravvicinati vadano letti come problema globale e non come una serie casuale di sostituzioni.
Ridurre il carico, congelare lo stato e acquisire i membri può essere preferibile. Livello RAID, numero di dischi instabili, copie disponibili e urgenza dei dati determinano la scelta.
Diagnosi
Cercare una causa comune oltre il disco
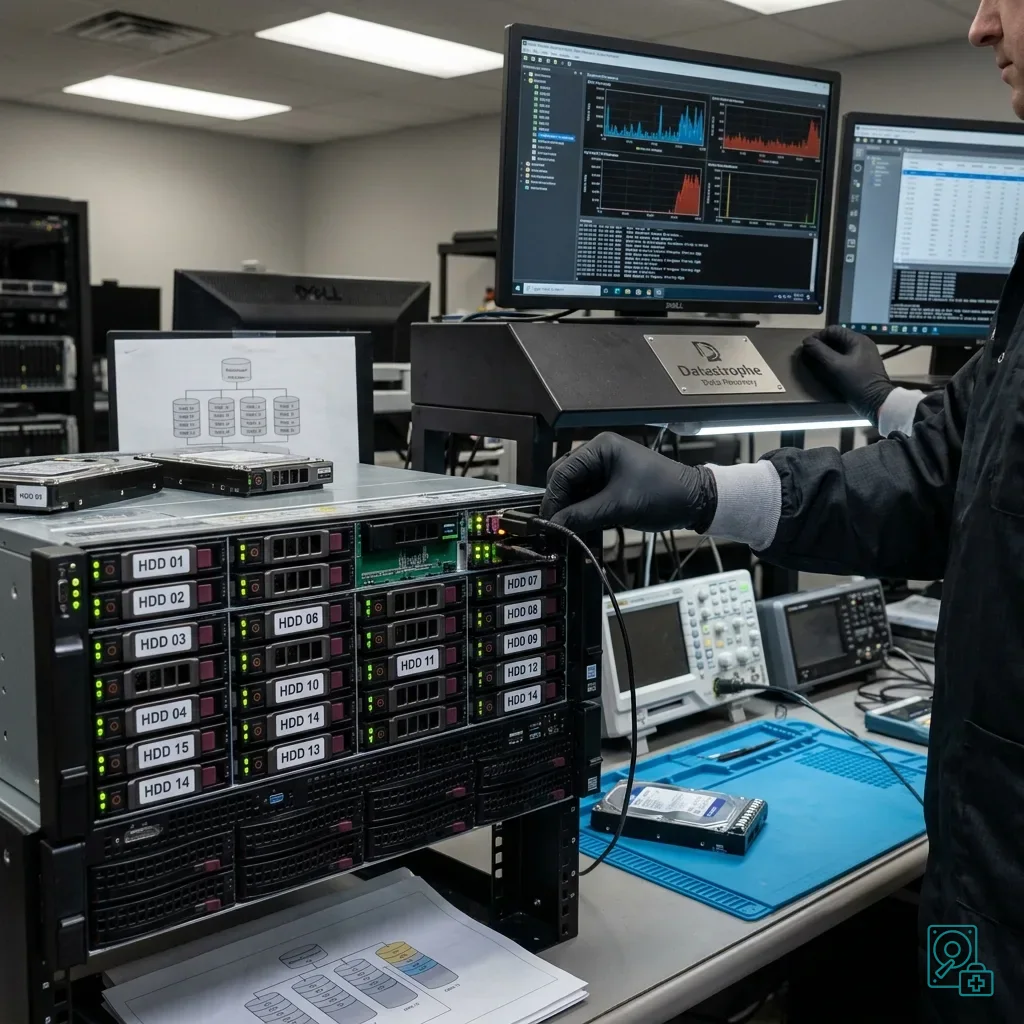
Controller, backplane, cavi, alimentazione e ventilazione possono produrre errori su più membri. Se restano fuori dalla diagnosi, sostituire drive non elimina la causa e avvia soltanto un altro rebuild.
Il backplane può perdere contatto o generare timeout intermittenti. Sotto la lettura continua della ricostruzione, una porta marginale diventa abbastanza instabile da far espellere un disco sano.
Calore e alimentazione peggiorano con il carico. Una baia densa, un flusso d'aria insufficiente o un alimentatore vicino al limite può fallire proprio quando tutti i membri lavorano insieme.
Il dossier su RAID, ridondanza e limiti ricorda che una causa condivisa non è coperta dalla parità. Anche errori amministrativi e configurazioni sbagliate vengono replicati dal sistema.
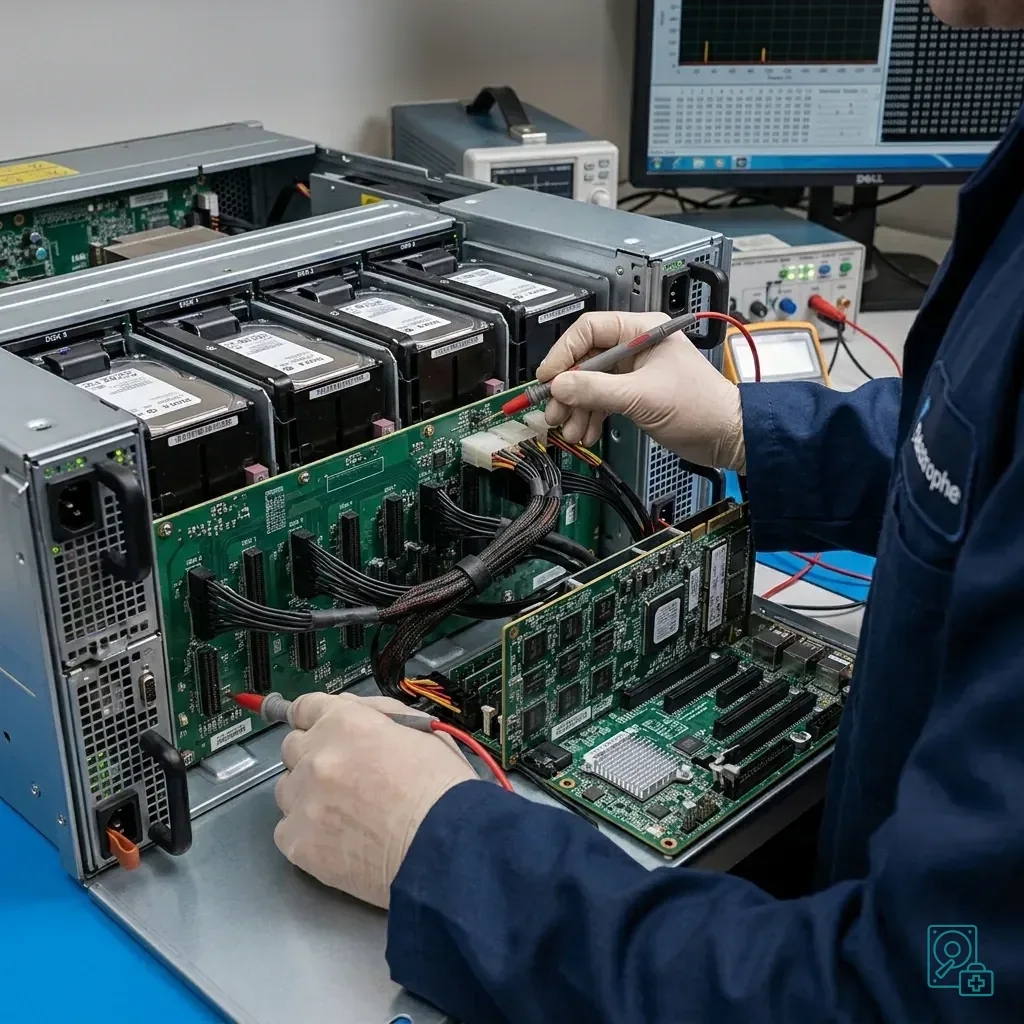
La diagnosi unisce hardware e logica: livello, ordine, metadati, generazioni, log e storia delle sostituzioni. Solo questa mappa indica che cosa possa essere acquisito e ricostruito con rischio controllato.
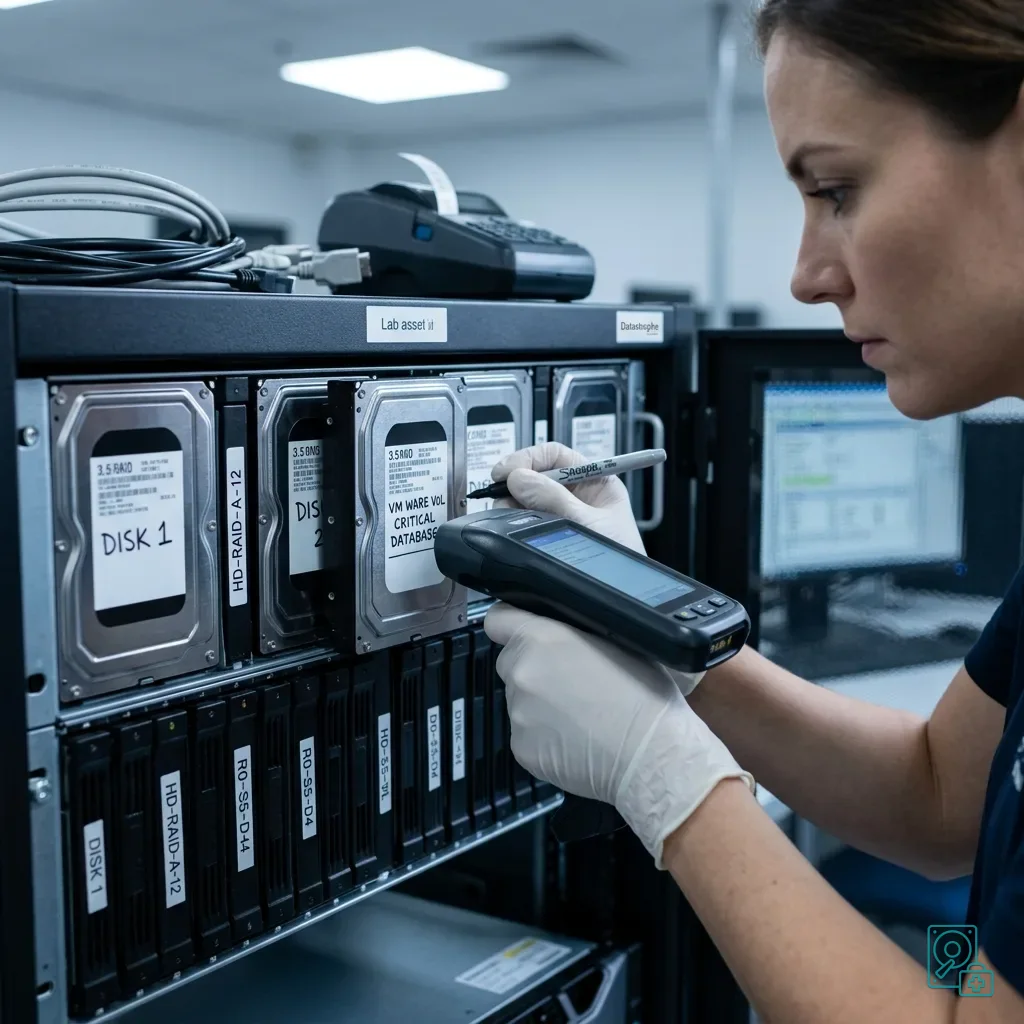
Diagnosi
Dare priorità ai dati prima di riavviare il volume
Database, VM, cartelle clienti, posta, produzione e archivi non hanno la stessa urgenza. Il piano ordina percorsi, date e dipendenze prima che l'obiettivo tecnico di completare il rebuild prenda il sopravvento.
Una ripresa temporanea può usare backup o storage separato, mantenendo disponibili i dischi originali. Ripristinare sul set o reinizializzarlo eliminerebbe il confronto con versioni ancora recuperabili.
La cronologia include drive cambiato, baia, ora, percentuale, errori, riavvii e backup avviati. Evita di ripetere la stessa operazione e permette di interpretare generazioni differenti.
La guida sui dati critici del server collega priorità aziendali e tecniche. Serve a scegliere tra continuità provvisoria, acquisizione mirata e ricostruzione completa.
Un volume tornato online viene verificato con file, database e VM. Il semaforo verde del controller non dimostra che scritture applicative e filesystem siano coerenti.
Diagnosi
Preparare un intervento sotto controllo
Le informazioni minime sono server, controller, livello, seriali, ordine, dischi sostituiti, log, alert e dati prioritari. Più il contesto è preciso, meno l'assemblaggio dipende da supposizioni.
I membri non vengono mescolati o testati senza traccia. Inversione, inizializzazione o importazione forzata possono riscrivere metadati necessari alla ricostruzione virtuale.
Se una parte del server deve restare disponibile, il vincolo viene dichiarato. Talvolta una ripresa separata protegge le fonti; altre volte l'arresto controllato è l'opzione meno rischiosa.
Datastrophe mantiene la priorità sui dati e distingue guasto del drive, causa comune, corruzione logica e limiti. Riavviare l'hardware resta un risultato diverso dal recuperare contenuti utilizzabili.
Dopo l'incidente servono backup provati, alert seguiti, configurazione documentata, ventilazione corretta e una procedura di rebuild. Queste misure evitano che un guasto isolato diventi una crisi.
Per sistemi virtualizzati, la verifica comprende datastore, file VM, snapshot e configurazioni. Un rebuild concluso lato controller può lasciare una macchina incoerente se le scritture erano state interrotte.
Diagnosi
Fonti tecniche primarie e limiti
Perimetro documentale — server carico rischi rebuild: Per RAID server carico rischi rebuild, le fonti primarie utilizzate sono Linux MD administration guide. Evidenza fisica — server carico rischi rebuild: Definiscono i concetti pertinenti di conservazione, struttura di archiviazione e convalida, ma non dimostrano lo stato fisico effettivo, il comportamento del controller, la disponibilità delle chiavi o la coerenza applicativa del dispositivo ricevuto. Evidenza del controller — server carico rischi rebuild: Questi aspetti richiedono misure sul gruppo originale e verifiche su copie.
Diagnosi
Richiedere una diagnosi controllata
Gruppo completo — server carico rischi rebuild: Per diagnosticare RAID server carico rischi rebuild, fornire il dispositivo o il gruppo completo, alimentatori e interfacce associati, ordine ed etichette dei membri, cronologia dei sintomi ed elenco preciso dei dati prioritari. Cronologia dell’incidente — server carico rischi rebuild: Le credenziali autorizzate vanno trasmesse tramite un canale protetto separato; non riavviare la sorgente solo per ottenere una nuova schermata.
Responsabilità del laboratorio — server carico rischi rebuild: Datastrophe esegue direttamente diagnosi, controlli di integrità e recupero nel proprio laboratorio con il proprio personale. Diagnosi gratuita — server carico rischi rebuild: Diagnosi e preventivo sono gratuiti. Limite del trasporto — server carico rischi rebuild: Il trasporto privato di andata e ritorno è incluso; il corriere sposta esclusivamente il pacco sigillato e non accede né tratta i dati.
Elenco controllato — server carico rischi rebuild: Prima di qualsiasi pagamento, il cliente riceve il prezzo proposto e un elenco verificato. Classi di verifica — server carico rischi rebuild: Ogni elemento è classificato, nell’ordine, come recoverable_verified, partial, detected_unverified o unrecoverable. Momento del pagamento — server carico rischi rebuild: Solo gli elementi recoverable_verified, aperti e giudicati utilizzabili, vengono presentati come recuperabili. Esito non verificato — server carico rischi rebuild: Il pagamento avviene dopo l’accettazione dell’elenco e del prezzo.
Esito non verificato — server carico rischi rebuild: Se non viene verificato alcun dato utilizzabile, il recupero non riesce oppure il cliente rifiuta elenco o prezzo, non è dovuto alcun costo standard. Ricambio eccezionale — server carico rischi rebuild: L’unica eccezione riguarda un ricambio raro, costoso e non rimborsabile, ordinabile soltanto dopo l’accettazione di una proposta separata, esplicita e quantificata.