
Diagnose
Wie Last aus einem Diskfehler einen kritischen Vorfall macht
Ein Server-RAID kann bei normaler Last unauffällig wirken. Fällt ein Mitglied aus und beginnt der Rebuild, ändert sich das Gleichgewicht: verbleibende Disks lesen deutlich mehr, der Controller berechnet und schreibt, während Anwendungen weiter auf das Volume zugreifen.
Unter diesem Druck werden vorhandene Schwächen sichtbar. Instabile Sektoren, hohe Temperatur, knappe Stromversorgung, fehlerhafte Backplane oder fast volles Volume können aus einem einzelnen Diskproblem einen Ausfall des gesamten Verbunds machen.
Warnzeichen sind steigende Latenz, I/O-Fehler, ein stockender Rebuild oder ein weiteres Mitglied, das offline geht. Ein noch antwortender Server ist nicht automatisch sicher. Diese Symptome lösen Lastreduktion und Zustandsdokumentation aus.
Die Datenrettung auf RAID-Systemen schützt den Quellverbund vor weiteren Schreibvorgängen. Im Serverkontext muss dabei die laufende Anwendungslast ausdrücklich von der technischen Rekonstruktion getrennt werden.
Erzwungener Rebuild, Rücksicherung auf dasselbe Volume und undokumentierter Neustart schaffen zusätzliche Zustände. Die sichere Reihenfolge lautet: Konfiguration erfassen, Prioritäten klären, Quellen sichern und erst danach eine Wiederanlaufmethode wählen.
Auch der Geschäftskalender zählt. Monatsabschluss, Vollbackup, Virenscan oder Massensynchronisation können die I/O-Last vervielfachen. Der Zeitpunkt des Rebuilds beeinflusst sein Risiko ebenso wie Diskzahl und RAID-Level.
Diagnose
Warum der Rebuild sämtliche I/O-Reserven beansprucht
Ein Rebuild liest die verbliebenen Mitglieder über ihre gesamte relevante Fläche und schreibt die rekonstruierte Information auf das Ersatzmedium. Anwendungslast, Backups und virtuelle Maschinen konkurrieren parallel um Controller, Queue und Diskköpfe.
Latente Sektorfehler fallen oft erst bei diesem Vollzugriff auf. Haben mehrere Disks dasselbe Alter und dieselbe thermische Geschichte, kann eine zweite unter Last ausfallen. Die nominelle RAID-Reserve schrumpft dann während des Wiederaufbaus.
Vor dem Start werden SMART-, Controller-, Betriebssystem- und Hypervisorlogs ausgewertet. Sie zeigen, ob nur eine Disk oder die gesamte Bay auffällig ist. Ein grüner Kurztest ersetzt keine Analyse wiederkehrender Timeouts.
Der Beitrag über wiederkehrende Ausfälle von Serverdisks ordnet solche Serienfehler ein. Mehrere nahe Ausfälle verlangen eine Ursachenanalyse und nicht nur schnellere Ersatzzyklen.
Je nach Datenwert kann es sicherer sein, produktive Last zu stoppen und Abbilder zu erstellen, bevor die Redundanz wiederhergestellt wird. Die Entscheidung berücksichtigt RAID-Level, Zahl instabiler Mitglieder, Backupqualität und Ausfallkosten.
Diagnose
Controller, Backplane und Stromversorgung einbeziehen
Der Verbund hängt von gemeinsamen Komponenten ab. RAID-Controller, Cache, Expander, Backplane, Kabel, Netzteile und Kühlung können mehrere Disks zugleich beeinflussen. Ein einzelner Tausch behebt keine Ursache, die außerhalb des Mediums liegt.
Backplanefehler erscheinen oft intermittierend. Eine Bay verliert kurz die Verbindung, sammelt CRC- oder Linkfehler und meldet danach wieder eine gesunde Disk. Unter Rebuildlast wird diese Instabilität besonders gefährlich.
Hohe Temperatur und Strombedarf steigen gleichzeitig mit der I/O-Last. In dicht bestückten Racks können Lüfterreserve und Netzteilkapazität knapp werden. Temperaturverlauf und Spannungsereignisse gehören deshalb zur Rebuilddiagnose.
Der Artikel über RAID-Redundanz und ihre Grenzen erinnert daran, dass gemeinsame Hardwareursachen mehrere Mitglieder außerhalb der vorgesehenen Ausfallannahme treffen können. RAID ist keine unabhängige Sicherung.
Die Diagnose verbindet Hardware und Logik: RAID-Level, Reihenfolge, Metadaten, physische Fehler, Dateisystem und Historie der Tauschaktionen. Nur dieser Gesamtblick zeigt, ob ein Rebuild überhaupt die richtige Maßnahme ist.
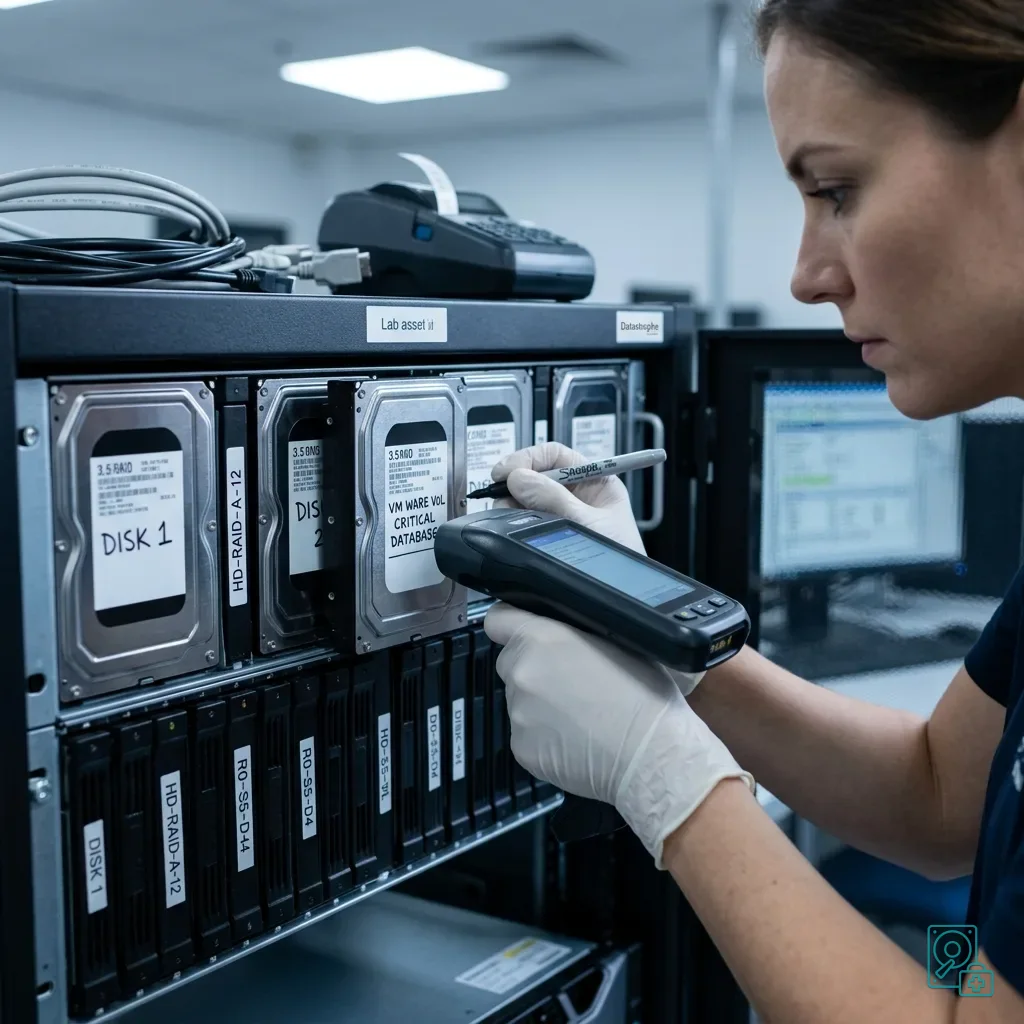
Diagnose
Daten priorisieren, bevor das Volume erneut startet
Ordnen Sie Geschäftsdaten vor technischen Maßnahmen. Produktionsdatenbank, virtuelle Maschinen, Kundenfreigaben, Mailstore und Archive haben unterschiedliche Dringlichkeit. Die größte Datenmenge ist nicht zwingend die wichtigste.
Ein Ersatzbetrieb kann aus einer bestätigten Sicherung auf neuer Infrastruktur starten. Die Originaldisks bleiben für Diagnose und Abbildung verfügbar. Eine Rücksicherung auf das beschädigte RAID wird vermieden.
Dokumentieren Sie bereits ausgeführte Diskwechsel, Bay-Positionen, Rebuildzeiten, Fortschritt, Neustarts und automatische Jobs. Diese Chronologie verhindert, dass dieselbe riskante Operation wiederholt oder ein veraltetes Mitglied bevorzugt wird.
Der Beitrag über kritische Daten auf Servern hilft, die fachliche Rangfolge zu formulieren. Sie steuert, welche Abbilder, Freigaben oder virtuellen Systeme zuerst ausgewertet und geprüft werden.
Ein wieder online kommendes Volume wird nicht sofort als gesund freigegeben. Prioritätsdateien, Datenbanken und virtuelle Maschinen erhalten echte Integritäts- und Anwendungstests. Erst danach folgt der kontrollierte Produktivstart.
Diagnose
Eine kontrollierte Intervention vorbereiten
Die Übergabe enthält Server- und Controllermodell, RAID-Level, vollständige Diskreihenfolge, alte sowie neue Mitglieder, Logs, Lastverlauf und priorisierte Daten. Diese Fakten reduzieren Layoutannahmen und unnötige Zugriffe.
Disks werden nicht gemischt oder einzeln an beliebigen Systemen getestet. Jede Bay und Seriennummer bleibt dokumentiert. Initialisierung und erzwungener Import sind bis zur Abbildung ausgeschlossen.
Muss ein Teil des Betriebs verfügbar bleiben, wird die Einschränkung offen benannt. Häufig kann eine getrennte Ersatzumgebung arbeiten, während die Quellen geschützt sind. In anderen Fällen ist ein geordneter Stopp die datenärmere Entscheidung.
Datastrophe untersucht physische Medien, gemeinsame Hardware und logische RAID-Struktur auf Abbildern. Ziel ist eine nutzbare Datenrückgabe, nicht nur der kurzfristige Neustart des ursprünglichen Servers.
Nach dem Vorfall bleiben die Präventionsmaßnahmen konkret: getestete Backups, aktuelle RAID-Dokumentation, überwachte Warnungen, ausreichende Kühlung und eine bekannte Rebuildfreigabe. Diese Grundlagen verhindern eine Wiederholung unter Zeitdruck.
Bei virtualisierten Hosts umfasst die Prüfliste Datastores, virtuelle Disks, Snapshots und VM-Konfigurationen. Ein abgeschlossener Controller-Rebuild kann dennoch inkonsistente Gastdateisysteme hinterlassen, wenn Schreibvorgänge während des Vorfalls unterbrochen wurden.
Diagnose
Primäre technische Quellen und Grenzen
Quellenrahmen — RAID Last Rebuild Risiken: Für Server RAID Last Rebuild Risiken werden als Primärquellen Linux MD administration guide herangezogen. Physischer Befund — RAID Last Rebuild Risiken: Sie beschreiben die maßgeblichen Konzepte für Sicherung, Speicherstruktur und Validierung, belegen aber weder den konkreten physischen Zustand noch Controllerstatus, Schlüsselverfügbarkeit oder fachliche Konsistenz des eingesandten Geräts. Controllerbefund — RAID Last Rebuild Risiken: Diese Punkte müssen am Originalverbund gemessen und an Kopien geprüft werden.
Diagnose
Kontrollierte Diagnose beauftragen
Vollständiger Verbund — RAID Last Rebuild Risiken: Für die Diagnose von Server RAID Last Rebuild Risiken sind das vollständige Gerät beziehungsweise alle zusammengehörigen Datenträger, Netzteile und Schnittstellenteile, ihre Reihenfolge, der Fehlerverlauf und die priorisierten Daten bereitzustellen. Störungsverlauf — RAID Last Rebuild Risiken: Zugangsdaten werden getrennt und geschützt übermittelt; ein weiterer Start nur für einen neuen Screenshot ist zu unterlassen.
Laborverantwortung — RAID Last Rebuild Risiken: Datastrophe führt Diagnose, Integritätskontrollen und Datenrettung mit dem eigenen Team im eigenen Labor durch. Kostenfreie Diagnose — RAID Last Rebuild Risiken: Diagnose und Kostenvoranschlag sind kostenlos. Transportgrenze — RAID Last Rebuild Risiken: Der private Hin- und Rücktransport ist inbegriffen; der Transporteur bewegt ausschließlich das versiegelte Paket und hat keinen Zugriff auf die Daten.
Geprüfte Liste — RAID Last Rebuild Risiken: Vor jeder Zahlung erhält der Kunde den vorgeschlagenen Preis und eine geprüfte Liste. Prüfklassen — RAID Last Rebuild Risiken: Die Elemente werden in dieser Reihenfolge als recoverable_verified, partial, detected_unverified oder unrecoverable eingestuft. Zahlungszeitpunkt — RAID Last Rebuild Risiken: Nur recoverable_verified-Elemente mit geprüftem, nutzbarem Inhalt werden als wiederherstellbar ausgewiesen. Ergebnislose Prüfung — RAID Last Rebuild Risiken: Gezahlt wird erst nach Annahme von Liste und Preis.
Ergebnislose Prüfung — RAID Last Rebuild Risiken: Werden keine nutzbaren Daten bestätigt, scheitert die Rettung oder lehnt der Kunde Liste beziehungsweise Preis ab, fallen keine Standardkosten an. Seltenes Ersatzteil — RAID Last Rebuild Risiken: Einzige Ausnahme ist ein seltenes, teures und nicht erstattungsfähiges Ersatzteil, das nur nach einer getrennten, ausdrücklichen und bezifferten Zustimmung bestellt werden darf.