
Diagnose
Bei wiederholten Ausfällen nach einer gemeinsamen Ursache suchen
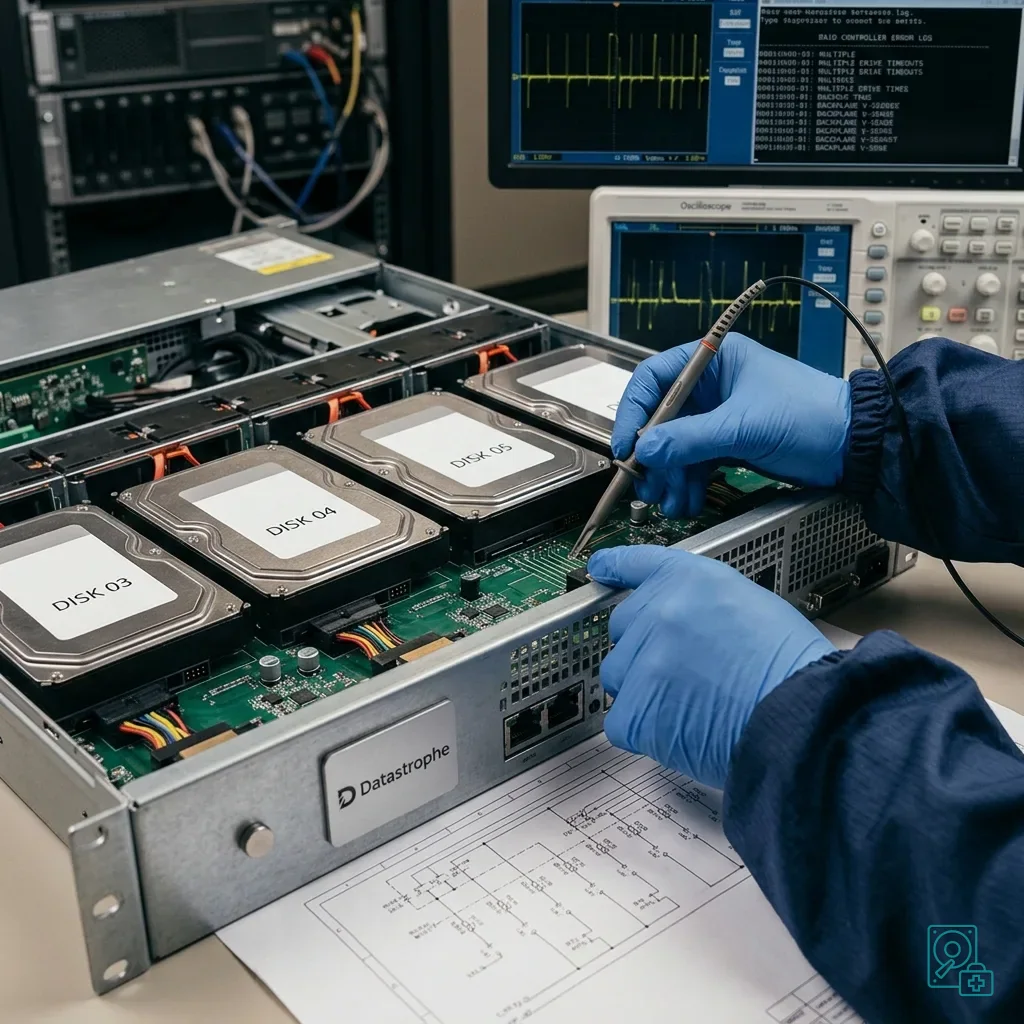
Bei einer einzelnen Fehlermeldung liegt ein Laufwerksdefekt nahe. Treten mehrere Warnungen innerhalb kurzer Zeit auf, muss die Betrachtung breiter werden. Wärme, Stromversorgung, Backplane, RAID-Controller, Vibrationen, Firmware oder vorherige Rebuilds können eine gemeinsame Ursache bilden.
Serverfestplatten arbeiten häufig dauerhaft unter hoher Last und teilen Gehäuse, Luftstrom und Strompfad. Mehrere Ausfälle sind deshalb nicht automatisch voneinander unabhängige Zufälle. Der zeitliche Zusammenhang gehört zum technischen Befund.
Führen Sie SMART-Warnungen, neu zugewiesene Sektoren, verschwindende Disks, I/O-Latenz, stockende Rebuilds und Controllerprotokolle in einer Zeitachse zusammen. Ergänzen Sie Netzteil- und Lüfteralarme. Erst das Gesamtbild zeigt ein wiederkehrendes Muster.
Die Datenrettung von Servern behandelt die Wiederherstellung von Serverdaten. Bei wiederholten Laufwerksfehlern liegt der Schwerpunkt zunächst darauf, die gemeinsame technische Ursache nicht durch hektische Austauschzyklen zu verdecken.
Jeder neue Rebuild liest die verbliebenen Festplatten intensiv. Ist eine weitere Disk bereits geschwächt, kann genau diese Last den Verbund über seine Fehlertoleranz bringen. Austausch und Rekonstruktion dürfen daher nicht reflexartig aufeinander folgen.
Auch nach einem Neustart verschwundene Warnungen bleiben relevant. Ein instabiler Kontakt oder eine grenzwertige Versorgung kann ein Laufwerk zeitweise zurückbringen. Solche intermittierenden Fehler sind kein Nachweis für einen wieder sicheren Zustand.
Diagnose
RAID, Backplane und Strompfad zusammen prüfen
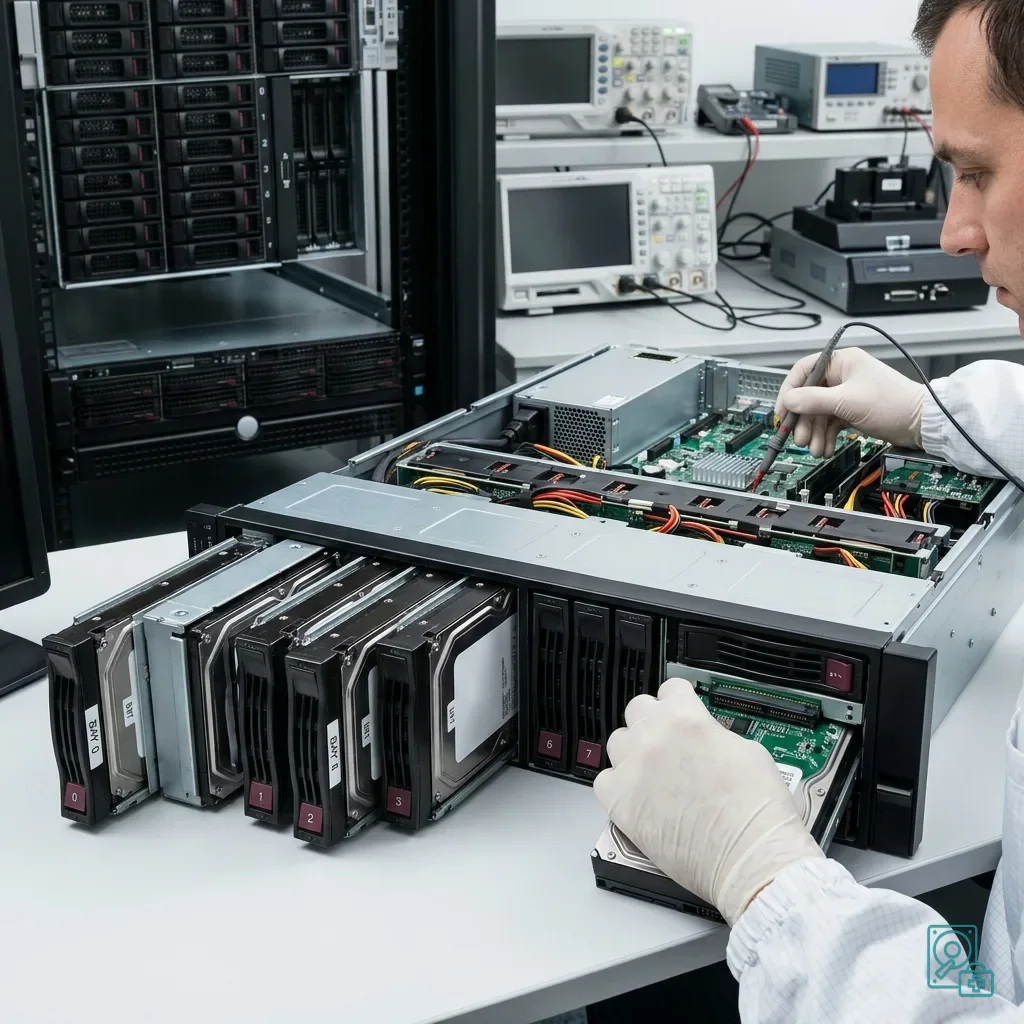
RAID kann einen einzelnen Ausfall überdecken, beseitigt aber keinen Fehler der gemeinsamen Infrastruktur. Ein instabiler Controller, eine beschädigte Backplane oder schwankende Versorgung kann gleichzeitig mehrere Disks als fehlerhaft erscheinen lassen.
Backplane-Stecker können durch Verschleiß, Oxidation oder schlechten Sitz intermittierende Abmeldungen verursachen. Der Controller meldet dann möglicherweise einen Diskfehler, obwohl Laufwerk und Schacht gemeinsam untersucht werden müssen. Slotwechsel ohne Dokumentation verwischt diesen Hinweis.
Wärme beeinflusst Elektronik und Mechanik. Verstopfte Luftwege, defekte Lüfter oder hohe Racktemperatur belasten besonders stark genutzte Laufwerke. Temperaturverläufe sind deshalb zusammen mit Last und Fehlerzeitpunkt zu sichern.
Der Artikel über kritische Serverdaten ordnet die fachlichen Prioritäten ein. Die Hardwarediagnose soll verhindern, dass ein voreiliger Wiederanlauf die letzten verwertbaren Quellen für diese Dienste beschädigt.
Exportieren Sie Controller-, System-, Hypervisor- und Monitoringprotokolle, bevor sie rotieren. Sie zeigen, welche Disk zuerst auffällig war, wann ein Rebuild startete und ob mehrere Fehler denselben Schacht oder Stromzweig betreffen.
Die Chronologie unterscheidet tatsächlich defekte Medien von Laufwerken, die nur den Kontakt verloren. Sie verhindert außerdem, dass eine für die Parität oder Konsistenz noch benötigte Disk irrtümlich entfernt oder initialisiert wird.
Diagnose
Keine Rekonstruktionen in Schleife ausführen
Ein RAID-Rebuild ist nur bei ausreichend stabilem Ausgangszustand sinnvoll. Sind mehrere Laufwerke schwach oder bleibt die gemeinsame Ursache unbekannt, können wiederholte Rekonstruktionen die letzten lesbaren Bereiche aufbrauchen.
Vermeiden Sie unprotokollierte Austausche, erzwungene Imports, Initialisierung, Löschen eines als „foreign“ markierten Datenträgers und Volume-Erweiterungen. Diese Maßnahmen verändern RAID-Metadaten und erschweren die spätere virtuelle Rekonstruktion.
Sichern Sie vor weiteren Schritten Laufwerksreihenfolge, RAID-Level, Stripe-Parameter, Controllerkonfiguration und aktuellen Status. Bei kritischen Daten sind kontrollierte Abbilder der instabilen Mitglieder oft geeigneter als ein direkter Rebuild.
Der Beitrag zu RAID-Redundanz und ihren Grenzen zeigt, warum Fehlertoleranz kein Backup ist. Bei zeitlich gehäuften Ausfällen kann die zulässige Zahl fehlender Mitglieder sehr schnell überschritten sein.
Ein wieder eingebundenes Volume ist noch nicht validiert. Dateisystem, virtuelle Disks und Datenbanken können nach Lesefehlern inkonsistent sein. Der Qualitätscheck folgt auf die technische Rekonstruktion und nicht nur auf einen grünen Controllerstatus.
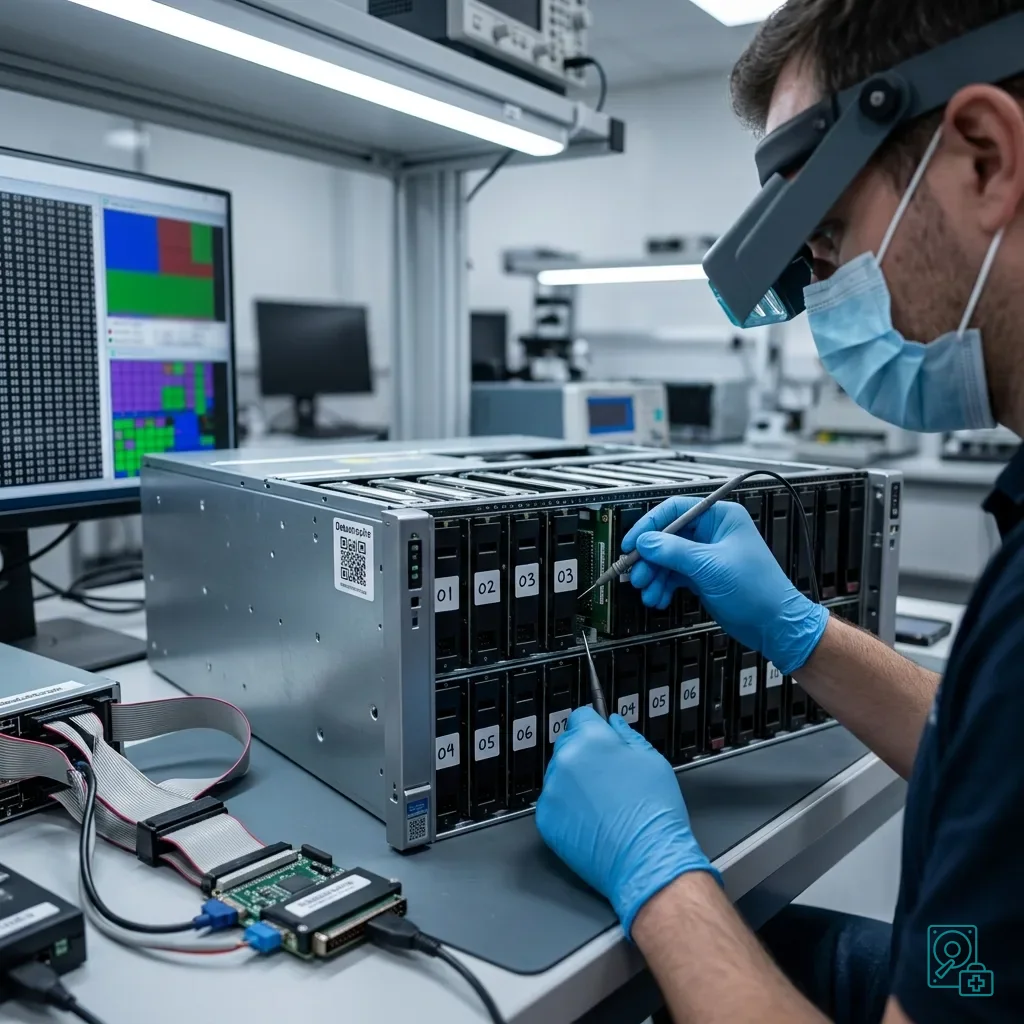
Diagnose
Dienste und geschäftskritische Daten priorisieren
Ordnen Sie Daten nach Geschäftsfunktion: Datenbank, Fileshare, E-Mail, virtuelle Maschinen und Produktionsdateien können unterschiedliche Wiederanlaufzeiten haben. Diese Rangfolge muss vor langen Auslese- oder Rekonstruktionsschritten feststehen.
Der Betrieb kann aus einer geprüften Sicherung oder Arbeitskopie anlaufen, ohne die Originaldisks zu überschreiben. Bewahren Sie den Verbund und seine Konfiguration für die Analyse auf. Wiederaufnahme und Datenrettung bleiben getrennte Arbeitsstränge.
Berücksichtigen Sie Anwendungsabhängigkeiten. Eine Datenbank ohne Journale, eine VM ohne Descriptor oder ein Share ohne Berechtigungsinformationen kann nur teilweise nutzbar sein. Die Priorität umfasst daher mehr als einzelne Dateien.
Der Datenwiederherstellungsplan für Unternehmen verbindet technische Schritte mit Verantwortlichkeiten. Vorab bekannte Geschäftsziele verkürzen die Diagnose und verhindern widersprüchliche Maßnahmen.
Kommunizieren Sie konkrete Zustände: „Volume degradiert, Rebuild gestoppt, Disks 2 und 4 instabil, Buchhaltungsdaten zuerst“. Eine solche Meldung ist handlungsfähiger als die allgemeine Aussage, der Server sei ausgefallen.
Diagnose
Ursache und Vorsorge nachvollziehbar dokumentieren
Nach dem Vorfall wird die gemeinsame Ursache behoben. Waren Wärme, Backplane oder Versorgung beteiligt, reicht der Austausch der Disks nicht. Gehäuse, Kühlung, Firmware, Monitoring und Backupstrategie werden gemeinsam überprüft.
Testen Sie Alarmwege. Eine SMART- oder RAID-Warnung, die tagelang unbeachtet bleibt, verwandelt einen tolerierten Einzelfehler in einen vollständigen Ausfall. Entscheidend ist die definierte Reaktion auf das Signal.
Backups müssen unabhängig und wiederherstellbar sein. Eine technisch erfolgreiche Sicherung im selben Storage oder ohne aktuelle Anwendungsdaten bietet keine verlässliche Betriebsaufnahme. RAID deckt nur einen begrenzten Teil der Risiken ab.
Pflegen Sie eine Serverakte mit Modell, Controller, RAID-Level, Slotreihenfolge, Kapazitäten, Firmware, Standort, Diensten und sicheren Handgriffen. Sie beschleunigt Entscheidungen, ohne den Verbund probeweise verändern zu müssen.
Datastrophe bewertet wiederholte Ausfälle und schwierige Rekonstruktionen mit dem Ziel, die Quellen zu bewahren und priorisierte Daten zu gewinnen. Unnötige Schreib- und Rebuild-Vorgänge werden begrenzt, während technische Grenzen dokumentiert bleiben.
In virtualisierten Umgebungen gehören Datastores, VM-Diskdateien und Snapshot-Ketten in dieselbe Analyse. Ein wieder startender Host beweist nicht, dass seine virtuellen Datenbestände vollständig oder anwendungskonsistent sind.
Diagnose
Primäre technische Quellen und Grenzen
Quellenrahmen — wiederholte Ausfälle Diagnose: Für Serverfestplatten wiederholte Ausfälle Diagnose werden als Primärquellen csrc.nist.gov herangezogen. Physischer Befund — wiederholte Ausfälle Diagnose: Sie beschreiben die maßgeblichen Konzepte für Sicherung, Speicherstruktur und Validierung, belegen aber weder den konkreten physischen Zustand noch Controllerstatus, Schlüsselverfügbarkeit oder fachliche Konsistenz des eingesandten Geräts. Controllerbefund — wiederholte Ausfälle Diagnose: Diese Punkte müssen am Originalverbund gemessen und an Kopien geprüft werden.
Diagnose
Kontrollierte Diagnose beauftragen
Vollständiger Verbund — wiederholte Ausfälle Diagnose: Für die Diagnose von Serverfestplatten wiederholte Ausfälle Diagnose sind das vollständige Gerät beziehungsweise alle zusammengehörigen Datenträger, Netzteile und Schnittstellenteile, ihre Reihenfolge, der Fehlerverlauf und die priorisierten Daten bereitzustellen. Störungsverlauf — wiederholte Ausfälle Diagnose: Zugangsdaten werden getrennt und geschützt übermittelt; ein weiterer Start nur für einen neuen Screenshot ist zu unterlassen.
Laborverantwortung — wiederholte Ausfälle Diagnose: Datastrophe führt Diagnose, Integritätskontrollen und Datenrettung mit dem eigenen Team im eigenen Labor durch. Kostenfreie Diagnose — wiederholte Ausfälle Diagnose: Diagnose und Kostenvoranschlag sind kostenlos. Transportgrenze — wiederholte Ausfälle Diagnose: Der private Hin- und Rücktransport ist inbegriffen; der Transporteur bewegt ausschließlich das versiegelte Paket und hat keinen Zugriff auf die Daten.
Geprüfte Liste — wiederholte Ausfälle Diagnose: Vor jeder Zahlung erhält der Kunde den vorgeschlagenen Preis und eine geprüfte Liste. Prüfklassen — wiederholte Ausfälle Diagnose: Die Elemente werden in dieser Reihenfolge als recoverable_verified, partial, detected_unverified oder unrecoverable eingestuft. Zahlungszeitpunkt — wiederholte Ausfälle Diagnose: Nur recoverable_verified-Elemente mit geprüftem, nutzbarem Inhalt werden als wiederherstellbar ausgewiesen. Ergebnislose Prüfung — wiederholte Ausfälle Diagnose: Gezahlt wird erst nach Annahme von Liste und Preis.
Ergebnislose Prüfung — wiederholte Ausfälle Diagnose: Werden keine nutzbaren Daten bestätigt, scheitert die Rettung oder lehnt der Kunde Liste beziehungsweise Preis ab, fallen keine Standardkosten an. Seltenes Ersatzteil — wiederholte Ausfälle Diagnose: Einzige Ausnahme ist ein seltenes, teures und nicht erstattungsfähiges Ersatzteil, das nur nach einer getrennten, ausdrücklichen und bezifferten Zustimmung bestellt werden darf.